Categoría: Datacenter

  • Por qué vDefend te puede ayudar con la seguridad y el movimiento lateral

    Por qué vDefend te puede ayudar con la seguridad y el movimiento lateral

    Durante años, la conversación sobre seguridad en el datacenter giró alrededor del perímetro: el firewall de borde, la VPN, el acceso desde Internet. Ese trabajo sigue siendo necesario, pero ya no alcanza. Hoy la pregunta que más pesa no es si un atacante puede entrar, sino qué tan lejos puede llegar una vez que entró. Y para responderla, en una nube privada con VMware Cloud Foundation, tenemos que hablar de vDefend.

    En resumen

    • Con la IA, los atacantes encuentran y explotan vulnerabilidades a velocidad de máquina. El tiempo para reaccionar se achicó a horas.
    • La mayor parte del daño de un ataque ocurre adentro: el atacante entra por un punto débil y se mueve de un servidor a otro hasta llegar a lo valioso.
    • vDefend pone un firewall e IDS/IPS en cada carga de trabajo de VCF. La versión anunciada en agosto de 2026 lo hace más rápido de desplegar, más simple de operar y compatible con entornos aislados.

    El problema no es solo que entren: es cuánto se mueven adentro

    Casi ningún ataque serio termina en el primer equipo comprometido. Un servidor web vulnerable, una credencial robada o un agente de IA mal configurado son apenas la puerta. Lo que sigue es el movimiento lateral: el atacante explora la red interna, salta a los servidores de aplicaciones, llega al Active Directory y, desde ahí, a las bases de datos y al backup. Es el patrón típico del ransomware.

    El firewall perimetral no ve ese recorrido, porque controla el tráfico que entra y sale (norte-sur), no el que circula entre servidores dentro del datacenter (este-oeste). Como dice Broadcom en su anuncio: la infiltración ocurre cuando el tráfico no se inspecciona. Por eso propone aplicar IDS/IPS a todas las cargas, no solo a las críticas.
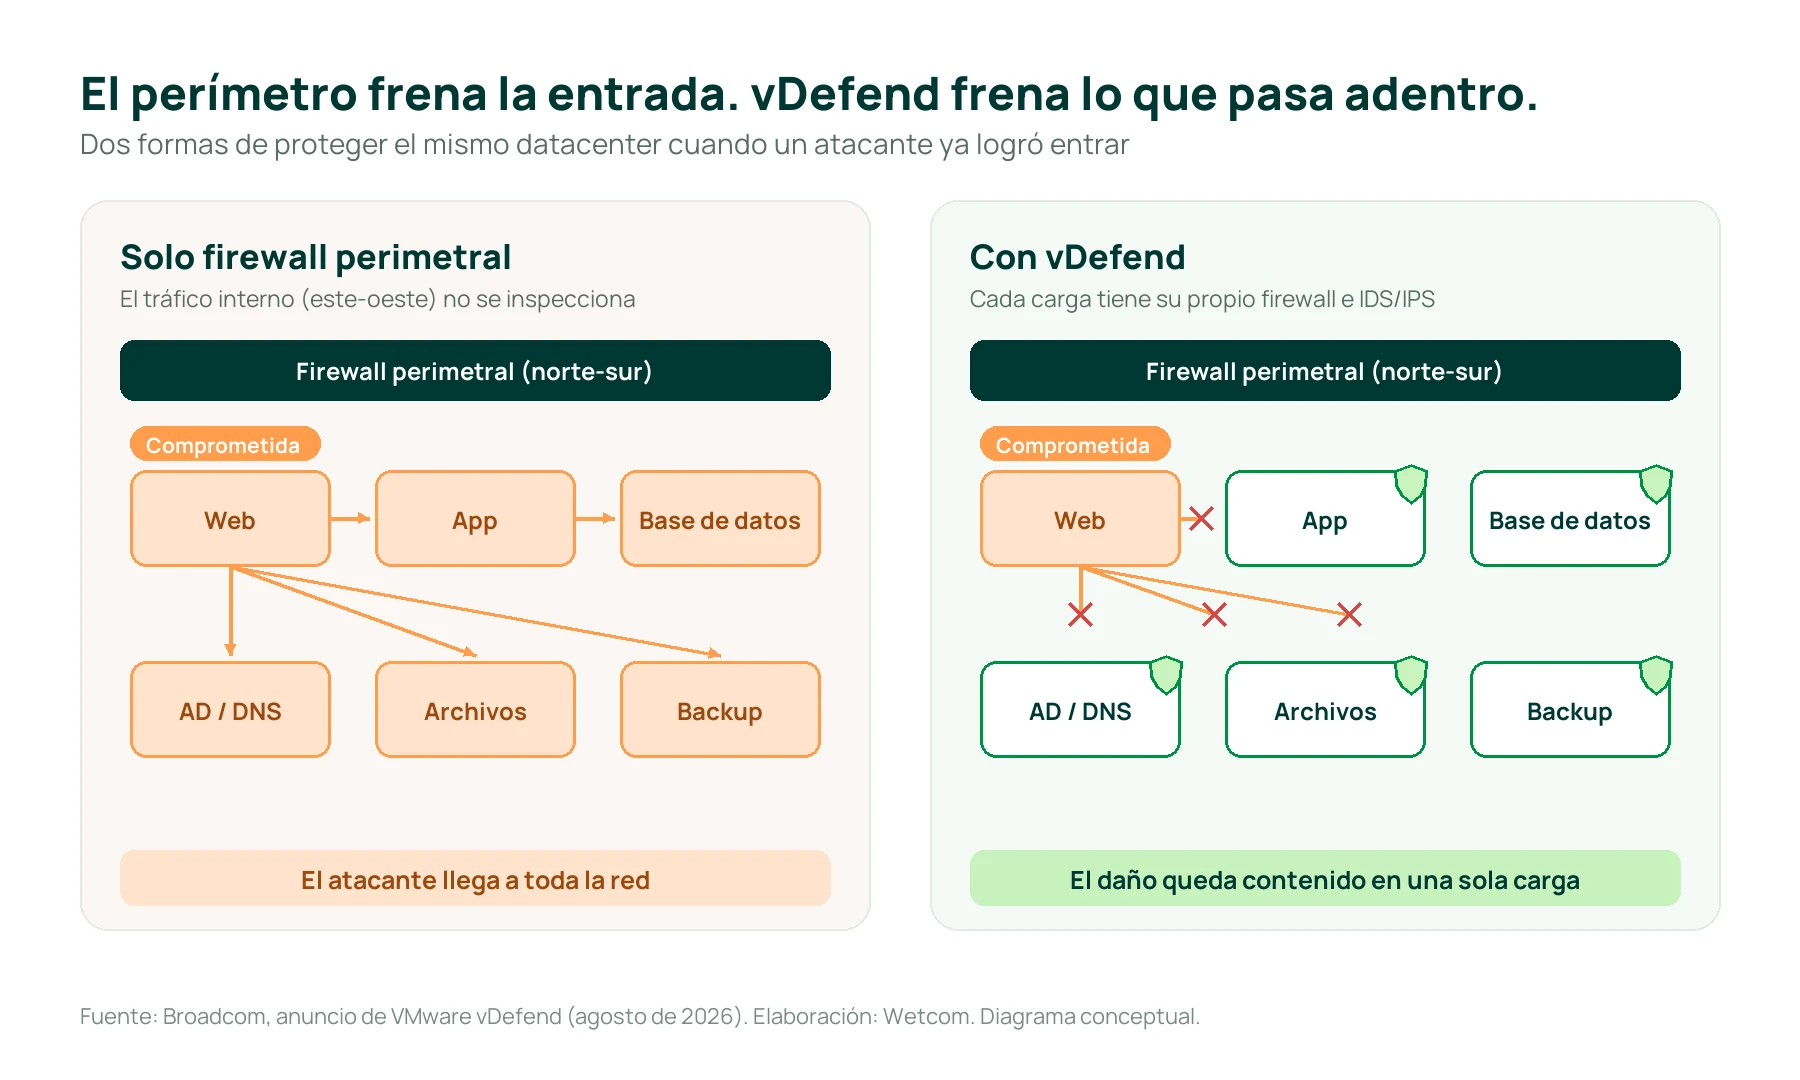
    Comparación entre un datacenter protegido solo con firewall perimetral, donde el atacante se mueve desde un servidor web comprometido a toda la red, y uno con VMware vDefend, donde cada carga tiene su firewall y el ataque queda contenido
    Figura 1. Con vDefend, cada carga de trabajo tiene su propio firewall e IDS/IPS y el atacante no puede saltar de un servidor a otro.

    A esto se suma la velocidad. Broadcom describe un escenario en el que los atacantes usan modelos de IA de frontera para explotar vulnerabilidades a velocidad de máquina, mientras la adopción de IA agéntica agranda la superficie de ataque. La ventana entre que se publica una vulnerabilidad y aparece el exploit ya no se mide en semanas.

    Qué es vDefend, en dos líneas

    VMware vDefend es la seguridad lateral de VMware Cloud Foundation. Incluye un firewall distribuido que corre en cada host ESX y protege cada VM y cada contenedor de vSphere Kubernetes Service, más protección avanzada: IDS/IPS distribuido con virtual patching, análisis de tráfico de red (NTA), detección y respuesta de red (NDR) y prevención de malware. Todo se gestiona desde la misma plataforma que ya usás para tu nube privada, sin instalar agentes en las VMs.

    Lo nuevo de vDefend: más protección, más simple y más rápido

    El 6 de agosto de 2026, Broadcom anunció una nueva versión, organizada en tres pilares.

    Más protección

    • vDefend 1-2-3 para ATP. Un flujo guiado en tres etapas para desplegar IDS/IPS, NTA y NDR. Según Broadcom, lleva la protección avanzada a producción en pocas semanas en lugar de muchos meses.
    • Prevención de malware on-premise. El análisis de archivos sospechosos (sandboxing) ahora corre dentro de tu datacenter: no hace falta subir archivos a una nube pública.
    • Soporte completo para entornos aislados (air-gapped). Todas las capacidades funcionan sin conexión a Internet, con actualizaciones de firmas que se cargan de forma manual.
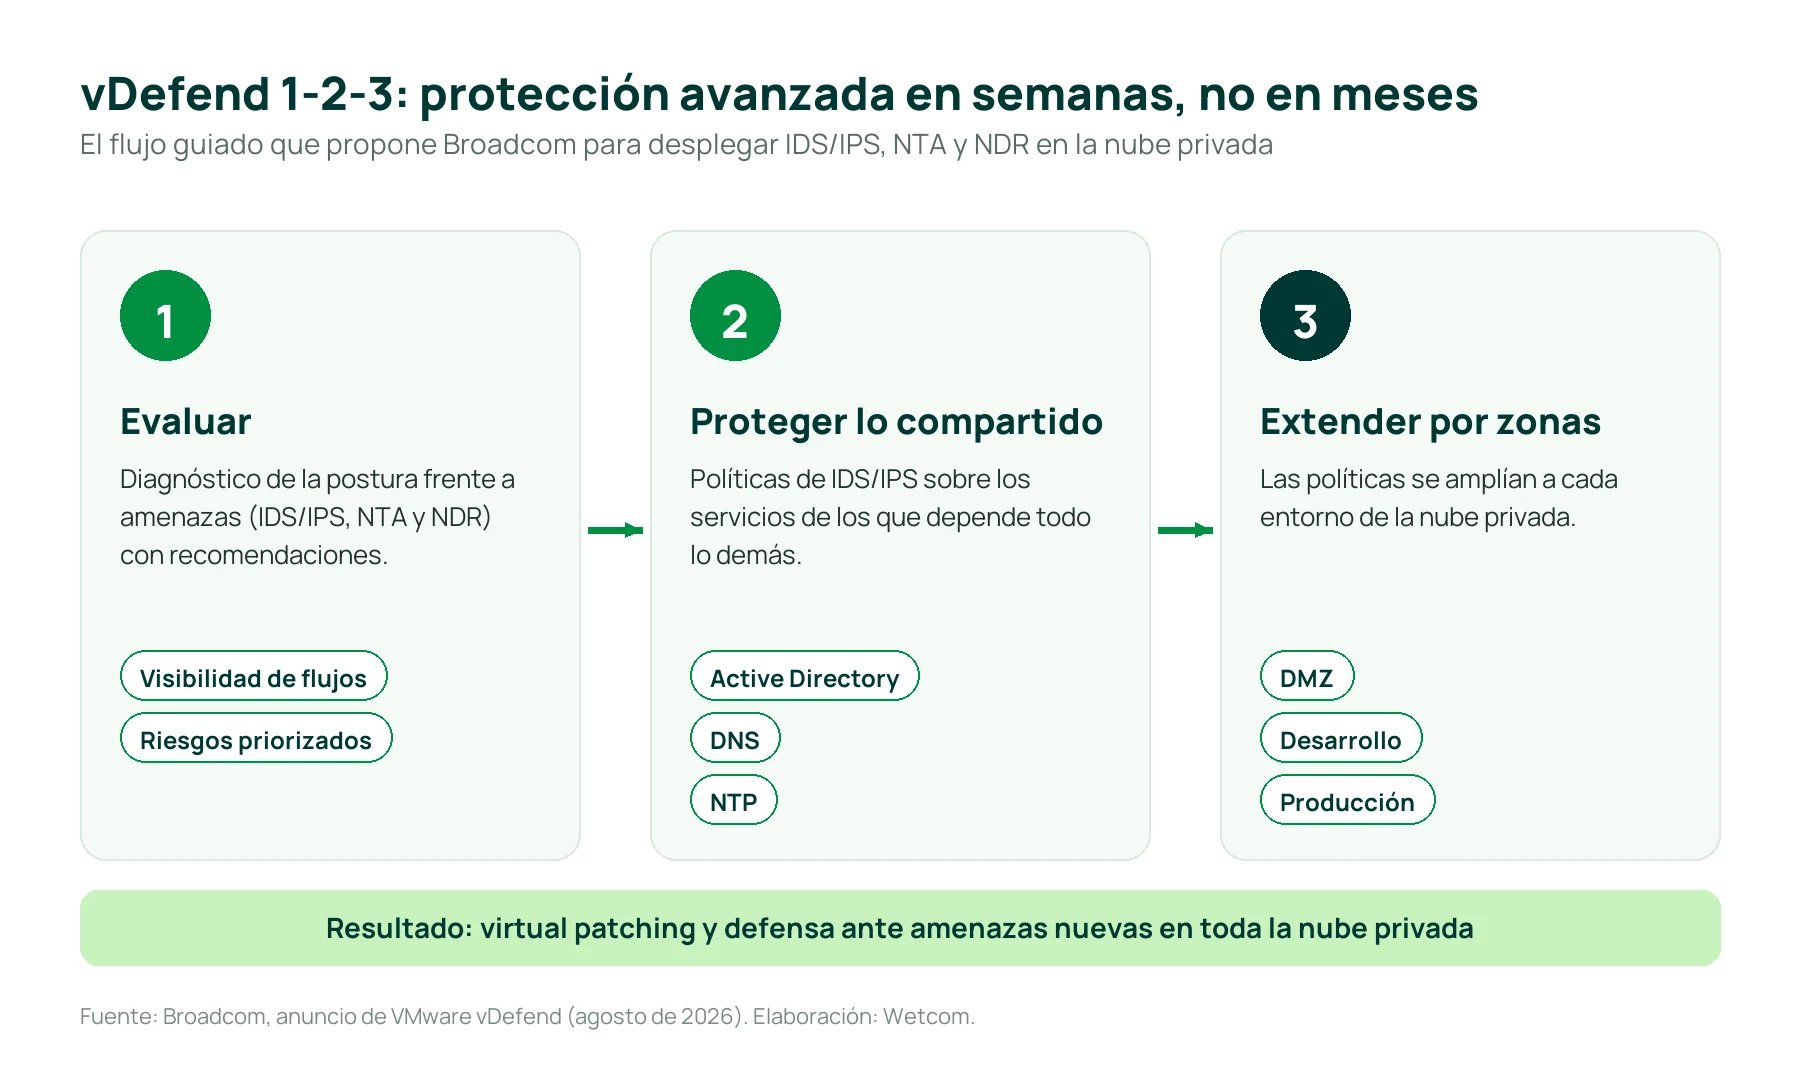
    Flujo vDefend 1-2-3 para protección avanzada en tres etapas: evaluar la postura frente a amenazas, proteger servicios compartidos como Active Directory, DNS y NTP, y extender las políticas a las zonas DMZ, desarrollo y producción
    Figura 2. vDefend 1-2-3 ordena el despliegue de la protección avanzada: primero lo que sostiene a todo lo demás, después cada zona.

    Operación más simple

    • AI Assistant para vDefend. Ayuda a diagnosticar problemas, da recomendaciones de diseño según la versión y analiza las reglas para encontrar duplicadas o redundantes y limpiar la política.
    • Migración automatizada. La herramienta vACT convierte las reglas de firewalls tradicionales basados en agentes a políticas nativas del firewall distribuido, con menos trabajo manual y menos errores.

    Más rendimiento con el mismo hardware

    ComponenteMejoraEscala
    Firewall distribuido22 Gbps por servidor con placas de 25G (+129 %) y 75 Gbps con placas de 100GHasta 75 Tbps por instancia de VCF
    IDS/IPS distribuido17 Gbps por servidor (+89 %)Hasta 17 Tbps por instancia de VCF
    Security Services PlatformNuevo modelo desde 32 núcleos de CPUHasta 33 % menos servidores físicos

    Las mejoras de rendimiento llegan con una actualización de software, sin cambiar servidores. Están disponibles en vDefend Security Services Platform 5.2, vDefend 9.1.1 y vACT 3.0, todas compatibles con VCF 9.1.

    Lo que un CISO tiene que saber

    • El riesgo se mide adentro. La pregunta para el directorio ya no es “¿estamos protegidos?”, sino “si entran, ¿hasta dónde llegan?”. La microsegmentación es la forma de acotar esa respuesta a una sola carga.
    • El virtual patching compra tiempo. El IDS/IPS distribuido bloquea la explotación de vulnerabilidades conocidas mientras el parche se prueba y se aplica. Con ataques que aparecen en horas, ese margen es crítico.
    • Los servicios compartidos son el objetivo. Active Directory, DNS y NTP sostienen a todo lo demás. Protegerlos primero, como propone vDefend 1-2-3, es la decisión de mayor impacto por peso invertido.
    • La soberanía de datos ya no es una excusa. Con el sandboxing on-premise y el soporte air-gapped, los sectores regulados pueden tener protección avanzada sin enviar archivos ni metadatos fuera del datacenter.
    • La IA agéntica necesita seguridad lateral desde el día uno. Los agentes conversan con sistemas internos usando protocolos como MCP. Broadcom participó en la propuesta para robustecer MCP que incorporó la especificación publicada en julio de 2026.
    • Ya no es un proyecto eterno. Con los flujos guiados, la microsegmentación y la protección avanzada se despliegan en semanas, y la migración desde firewalls con agentes se automatiza.

    Por qué vDefend tiene que dejar de ser opcional

    Muchas empresas compraron VMware Cloud Foundation y dejaron la seguridad lateral “para la próxima etapa”. Esa decisión tenía sentido cuando desplegar microsegmentación llevaba un año y el atacante necesitaba semanas para moverse. Hoy ninguna de las dos cosas es cierta.

    • Ya tenés la plataforma. vDefend se suma a VCF: no requiere appliances nuevos en el camino del tráfico ni agentes en las VMs.
    • El costo de no tenerlo es asimétrico. Un incidente de ransomware que llega al Active Directory y al backup cuesta mucho más que la protección que lo hubiera contenido.
    • El tiempo juega en contra. Cada mes sin inspección este-oeste es un mes en el que un atacante podría moverse sin que nadie lo vea.

    Nuestra recomendación para los clientes con VCF es clara: la seguridad lateral tiene que estar en el plan de este año, empezando por los servicios compartidos y las aplicaciones críticas.

    Cómo lo implementamos en Wetcom

    1. Diagnóstico. Activamos la Security Services Platform para ver los flujos reales entre tus cargas, medir la postura de seguridad y priorizar riesgos. Sin bloquear nada todavía.
    2. Segmentación. Aplicamos la microsegmentación por etapas, siguiendo el método vDefend 1-2-3-4 para el firewall distribuido: primero zonas, después aplicaciones y, por último, cada carga.
    3. Protección avanzada. Desplegamos IDS/IPS, NTA y NDR con vDefend 1-2-3: servicios compartidos primero, después DMZ, desarrollo y producción. Si venís de un firewall con agentes, migramos las reglas con vACT.
    4. Operación. Con nuestro servicio de Networking & Security monitoreamos 7×24, ajustamos políticas y atendemos alertas. Ante un incidente crítico, Insane Support escala directo con Broadcom.

    vDefend es una capa de una defensa en profundidad que completamos con Avi WAAP para las aplicaciones y APIs expuestas, VMware HyperArmor para el propio hipervisor y nuestro servicio de Ransomware Incident Response. Como Partner Pinnacle de Broadcom, también te ayudamos a dimensionar y contratar las licencias que necesitás.

    ¿Hasta dónde llegaría hoy un atacante dentro de tu nube privada? Agendá un diagnóstico de seguridad lateral con nuestros especialistas.

    Preguntas frecuentes

    ¿vDefend reemplaza al firewall perimetral?

    No. El firewall perimetral sigue controlando lo que entra y sale del datacenter. vDefend protege el tráfico interno, entre servidores, que el perímetro no ve. Se complementan.

    ¿Hay que instalar agentes en las VMs?

    No. El firewall distribuido y el IDS/IPS de vDefend corren en el hipervisor ESX de VMware Cloud Foundation, sin agentes en los sistemas operativos.

    ¿Protege también contenedores?

    Sí. Desde VCF 9.1, vDefend ofrece protección lateral unificada para VMs y para cargas de vSphere Kubernetes Service.

    ¿Cuánto lleva implementarlo?

    Depende del tamaño y la complejidad del entorno. Con los flujos guiados de Broadcom, la microsegmentación y la protección avanzada se despliegan en semanas, por etapas y sin cortar el servicio.

    ¿Cómo se contrata?

    vDefend se contrata como complemento de VMware Cloud Foundation. Consultanos y te armamos la propuesta según tus cargas y prioridades.

    Fuentes

    Lecturas relacionadas

    Sobre el autor
    Diego Quintana es CEO & Co-Founder de Wetcom, Partner Pinnacle de VMware by Broadcom, y Principal Cloud & Infrastructure Architect de la compañía. Fue reconocido 17 veces como VMware vExpert. Trabaja en el diseño de nubes privadas, seguridad y continuidad de negocio para empresas de América Latina.
  • Máxima Protección en VMware VCF 9.1.1: El Rol de TPM y vTPM

    Máxima Protección en VMware VCF 9.1.1: El Rol de TPM y vTPM

    Qué protege cada uno y cómo usarlo en los ESX, Windows Server y Linux

    Hoy hablaremos de una tecnología fundamental para optimizar y asegurar los centros de datos modernos: el Virtual TPM (vTPM) en VMware vSphere.

    La ciberseguridad ya no es un adicional, es el núcleo de la operación. Para entender el impacto del vTPM, primero debemos comprender cómo funciona la seguridad por hardware tradicional y por qué escalarla en entornos virtualizados era un desafío.

    Dos cosas con el mismo nombre

    Un TPM (Trusted Platform Module) es un chip que genera y guarda claves criptográficas de modo que no se pueden extraer de él. Cada chip trae una Endorsement Key (EK) provisionada de fábrica, única y no migrable, que sirve para identificarlo y demostrar que es genuino. Sobre esa base se arma la jerarquía de almacenamiento, cuya clave raíz es la Storage Root Key (SRK): las demás claves se guardan cifradas bajo ella y solo se pueden abrir dentro del chip. Si se limpia el TPM se genera una SRK nueva, y lo que estaba protegido con la anterior deja de poder abrirse.

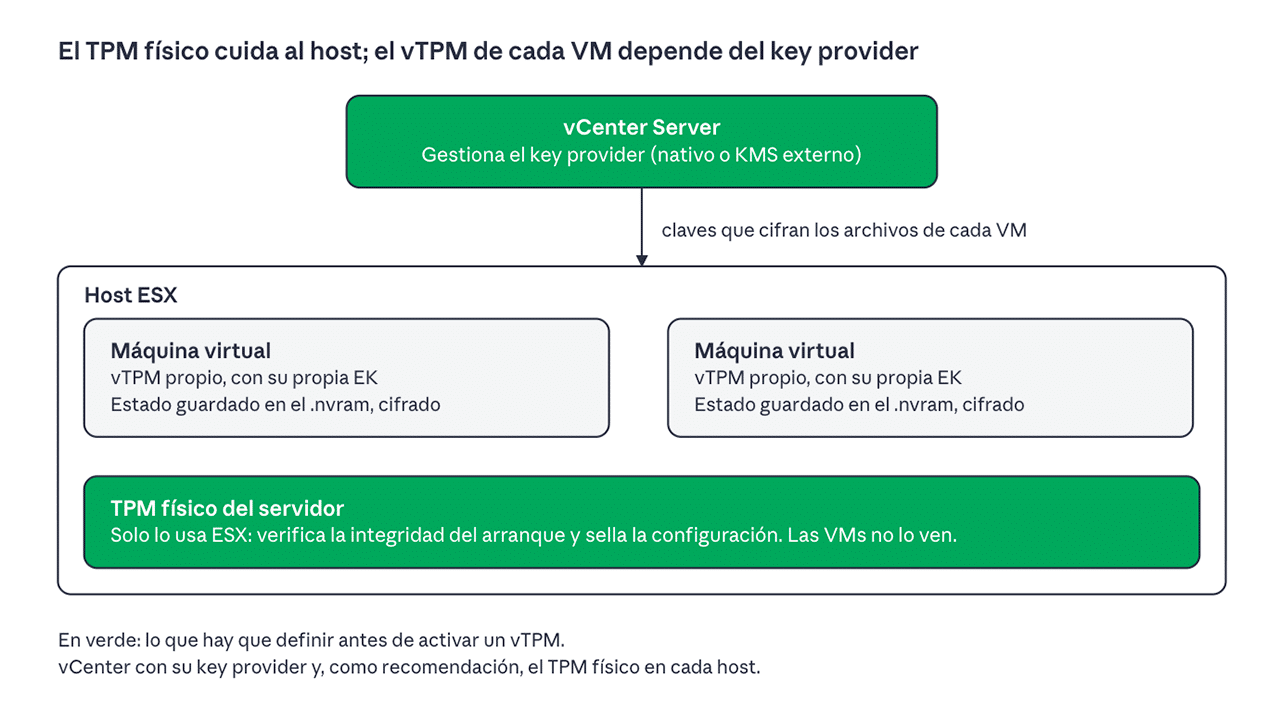
    En un entorno VCF 9 hay que distinguir dos TPM:

    • El TPM físico es un chip del servidor y lo usa solamente el hipervisor. Las máquinas virtuales no pueden acceder a él.
    • El vTPM es un dispositivo virtual que se agrega a cada VM. El sistema operativo invitado, Windows Server o Linux, lo ve como un TPM 2.0 común.
    Diagrama de TPM y vTPM en VMware Cloud Foundation: vCenter gestiona el key provider que cifra los archivos de cada VM, cada máquina virtual tiene su propio vTPM y el TPM físico del servidor solo lo usa ESX

    El chip físico queda del lado del host. Las claves que protegen el vTPM de cada VM salen del key provider que administra vCenter.

    Qué hace el TPM físico en el host

    En ESX, el nombre que tiene el hipervisor desde VCF 9 (antes ESXi), el chip cumple dos funciones. La primera es la verificación de integridad del arranque: Secure Boot hace que el host solo cargue software firmado, y el TPM registra las mediciones de ese arranque para que vCenter pueda comprobar, y mostrar, si el host arrancó en un estado confiable. La segunda es sellar la configuración: cuando el servidor tiene TPM, la clave que cifra la configuración de ESX queda guardada en el chip y atada a ese equipo.

    Esto ayuda frente a un ransomware que apunta al hipervisor, pero no conviene sobreestimarlo. El TPM no frena un ataque por sí solo: permite detectar que el host fue modificado y protege su configuración y sus claves. Funciona como una capa dentro de un esquema que también incluye Secure Boot, lockdown mode, control de accesos y backups inmutables.

    Broadcom recomienda TPM 2.0 en los hosts de VCF 9. Hay un cambio que importa si venís de 9.0: en esa versión los hosts con TPM no podían usar live patch, y desde 9.1 ESX live patch soporta servidores con TPM habilitado, así que ya no hay que elegir entre una cosa y la otra. Una advertencia sobre hardware: lo que estaba soportado para ESXi 8 no queda soportado automáticamente en ESX 9, así que hay que validar cada servidor contra la Broadcom Compatibility Guide.

    Qué es el vTPM y dónde guarda sus datos

    El vTPM implementa la especificación TPM 2.0 como un dispositivo virtual de la VM; en VCF 9 se actualizó a la revisión 1.59. Cada máquina tiene el suyo, con su propia EK y su propio estado, y el sistema operativo lo usa igual que a un chip físico. No usa el TPM del servidor ni ningún otro hardware.

    El estado del vTPM se guarda en el archivo .nvram de la VM, y ese archivo se cifra con VM Encryption. De ahí salen dos consecuencias prácticas. Para agregar un vTPM hay que tener un key provider configurado en vCenter. Y al agregarlo se cifran los archivos de la carpeta de la VM, como el .nvram y el swap, pero no los discos virtuales: cifrar los VMDK es una decisión aparte.

    Un detalle para quienes necesitan verificar la identidad de una VM: la EK de un vTPM no la provee un fabricante de chips, la emite VMware Certificate Authority (VMCA) o una CA de terceros. La confianza que se obtiene es la de esa CA.

    Qué hay que tener para activarlo

    Partimos de VCF 9.1.1 o superior. Los requisitos son pocos, pero hay que leerlos con cuidado:

    • vCenter administrando los hosts ESX y VM Encryption disponible, porque el vTPM depende de él.
    • Un key provider configurado en vCenter, que puede ser el Native Key Provider (NKP) o un KMS externo. VCF 9 agrega una opción al key provider estándar: una wrapping key que protege a la clave que protege los datos, de modo que en el KMS queda una sola clave por administrar y puede rotar sola con la frecuencia que definas.
    • VMs con firmware EFI y compatibilidad de hardware virtual actual. Para Linux, la documentación de VMware pide como mínimo la compatibilidad de 7.0 Update 2.
    • VM apagada al momento de agregar el dispositivo.
    • Licencias: según VMware, vTPM y NKP están licenciados en todas las versiones de vSphere. Cifrar los discos de las VMs es otra cosa y conviene confirmarlo contra tu suscripción.

    Si el vTPM no aparece al intentar agregarlo, las causas habituales son una compatibilidad de VM baja, firmware BIOS en lugar de EFI, un key provider ausente o no confiable, o la VM encendida.

    Hay dos decisiones del key provider que conviene tomar desde el principio. Si usás Native Key Provider, hacé el backup de la clave apenas lo creás: sin ella no se pueden abrir las VMs cifradas si hay que reconstruir vCenter. Y evaluá activar la opción que limita el uso del NKP a hosts con TPM protegido. Es la recomendada, pero exige que todos los hosts del cluster tengan el chip. Es el punto donde el TPM físico y el vTPM se tocan.

    La documentación de vSphere indica además dos limitaciones del NKP: solo funciona con hosts dentro de un cluster, y si movés un host a otro cluster que no tiene el mismo NKP, las VMs cifradas quedan bloqueadas.

    Cómo se usa en Windows Server y en Linux

    VMware soporta el vTPM con guests Windows Server y Linux. Lo que cambia es qué se hace con él.

    Windows Server

    • BitLocker. El vTPM lo soporta, y el volumen queda sellado al TPM virtual de cada VM. En Windows Server hay que instalar la característica BitLocker.
    • Credential Guard y Device Guard. Usan seguridad basada en virtualización (VBS), que requiere configuración adicional en la VM y en el sistema operativo invitado. VBS no exige TPM, pero Windows lo aprovecha si está presente. En controladores de dominio, revisá primero las recomendaciones de Microsoft.

    Linux

    • Cifrado de disco sellado al TPM. Con LUKS2 y herramientas como systemd-cryptenroll o Clevis, el volumen se abre solo si el arranque no fue alterado, usando el vTPM de la VM.
    • Requisitos del lado del sistema operativo. Un kernel con soporte de TPM 2.0, que traen las distribuciones actuales, y firmware EFI con Secure Boot si querés que el arranque quede medido.
    • Antes de estandarizar una distribución, probá el sellado con la versión de kernel y de systemd que vayas a usar. El soporte del lado del sistema operativo depende de cada distribución, no de VMware.

    Rendimiento

    El vTPM mueve muy poco I/O. Los sistemas operativos guardan kilobytes en un TPM y lo consultan poco, así que el impacto es mínimo. Hay dos cosas para tener en cuenta.

    Puede notarse una pequeña diferencia en el tiempo de arranque de la VM. Y como los archivos de la VM se cifran, el swap también queda cifrado. Si el host está paginando memoria de las VMs a disco por sobreasignación, ese cifrado consume CPU adicional. En un cluster bien dimensionado, que no pagina, no debería notarse.

    Como los discos no se cifran por defecto, el storage sigue deduplicando y comprimiendo los VMDK igual que antes.

    Operación diaria: vMotion, clonado y backup

    • vMotion y Storage vMotion. Funcionan con VMs que tienen vTPM. El vMotion de una VM cifrada va cifrado, y los hosts de destino necesitan acceso al mismo key provider. VCF 9.1 puede delegar ese cifrado a Intel QAT en los servidores que lo tengan, y Broadcom documenta ahorros de hasta 67% de CPU en el origen y 22% en el destino.
    • Clonado. Desde vSphere 8.0, al clonar una VM con vTPM se elige entre copiar el vTPM o reemplazarlo. Con Reemplazar, la VM nueva arranca con un vTPM vacío, con su propia identidad y sus propios secretos. Para templates y clones recomendamos Reemplazar: copiar el vTPM deja dos VMs con la misma identidad y los mismos secretos.
    • Volúmenes sellados. En VMs con BitLocker o LUKS sellados al vTPM, reemplazarlo invalida el sellado. Hay que tener a mano la clave de recuperación y volver a sellar el volumen contra el vTPM nuevo.
    • Despliegues automatizados. vSphere 8 también permite definir una política de aprovisionamiento de TPM para que el reemplazo se haga solo al clonar o desplegar.
    • Backup y restore. Como los archivos de la VM están cifrados, las claves tienen que estar disponibles al momento de restaurar. Antes de ir a producción probá un restore completo de una VM con vTPM, tanto Windows Server como Linux, incluyendo el caso en que el vCenter original ya no existe.

    Cómo lo encaramos en Wetcom

    En nuestros proyectos tratamos el TPM y vTPM con la seriedad que requiere a la hora del diseño y no como una casilla en la configuración de la VM y listo.
    Antes de activarlo en VCF 9.1.1 o superior definimos qué key provider se usa, dónde queda el backup de sus claves, si los hosts tienen TPM físico, cómo se clonan los templates, qué se sella en cada VM (BitLocker en Windows Server, LUKS en Linux) y cómo se prueba el restore. Con eso resuelto, agregar el vTPM a una VM es una operación simple.

  • Avi WAAP: cómo proteger tus APIs y aplicaciones web en VMware Cloud Foundation

    Avi WAAP: cómo proteger tus APIs y aplicaciones web en VMware Cloud Foundation

    El 6 de agosto, Broadcom anunció que VMware Avi Load Balancer pasa de ser un WAF a una plataforma WAAP (Web Application and API Protection): suma protección de APIs, incorpora un asistente con IA generativa para la operación y mejora su rendimiento. Para un CIO o un CISO, la novedad abre una pregunta más importante que cualquier detalle técnico: ¿sabemos qué APIs tenemos expuestas y quién las está protegiendo?

    En resumen

    • Avi WAAP une en una sola capa el WAF, la protección de APIs, la gestión de bots, el rate limiting y la defensa contra DDoS, dentro del mismo balanceador que ya reparte el tráfico.
    • Descubre las APIs a partir del tráfico real y las clasifica en Shadow, Orphan, Zombie y Active, para que sepas qué está expuesto sin depender de un inventario manual.
    • El AI Assistant para Avi responde preguntas en lenguaje natural sobre la plataforma y ayuda a encontrar la causa de un problema más rápido.

    Por qué las APIs son hoy el frente más expuesto

    Cada aplicación moderna es, en realidad, un conjunto de APIs: la app móvil, el portal de clientes, las integraciones con socios y, cada vez más, los agentes de IA que consultan sistemas internos. Kubernetes y los microservicios multiplican esas APIs, y muchas se publican sin pasar por el equipo de seguridad.

    Los números que cita Broadcom muestran el impacto: según el estudio de Akamai sobre seguridad de APIs 2026, cerca del 87 % de las organizaciones sufrió un incidente de seguridad de APIs en el último año. Y según el informe ThreatStats 2026 de Wallarm, el 43 % de las vulnerabilidades que CISA sumó a su catálogo de vulnerabilidades explotadas activamente (KEV) están relacionadas con APIs.

    Un WAF tradicional sigue siendo necesario: frena los ataques web más conocidos del OWASP Top 10, como la inyección SQL o el cross-site scripting. Pero no conoce el contrato de cada API, no sabe cuáles existen ni distingue una llamada legítima de un abuso que respeta el formato. Ahí está el hueco que viene a cubrir un WAAP.

    Qué es WAAP y qué cambia con Avi

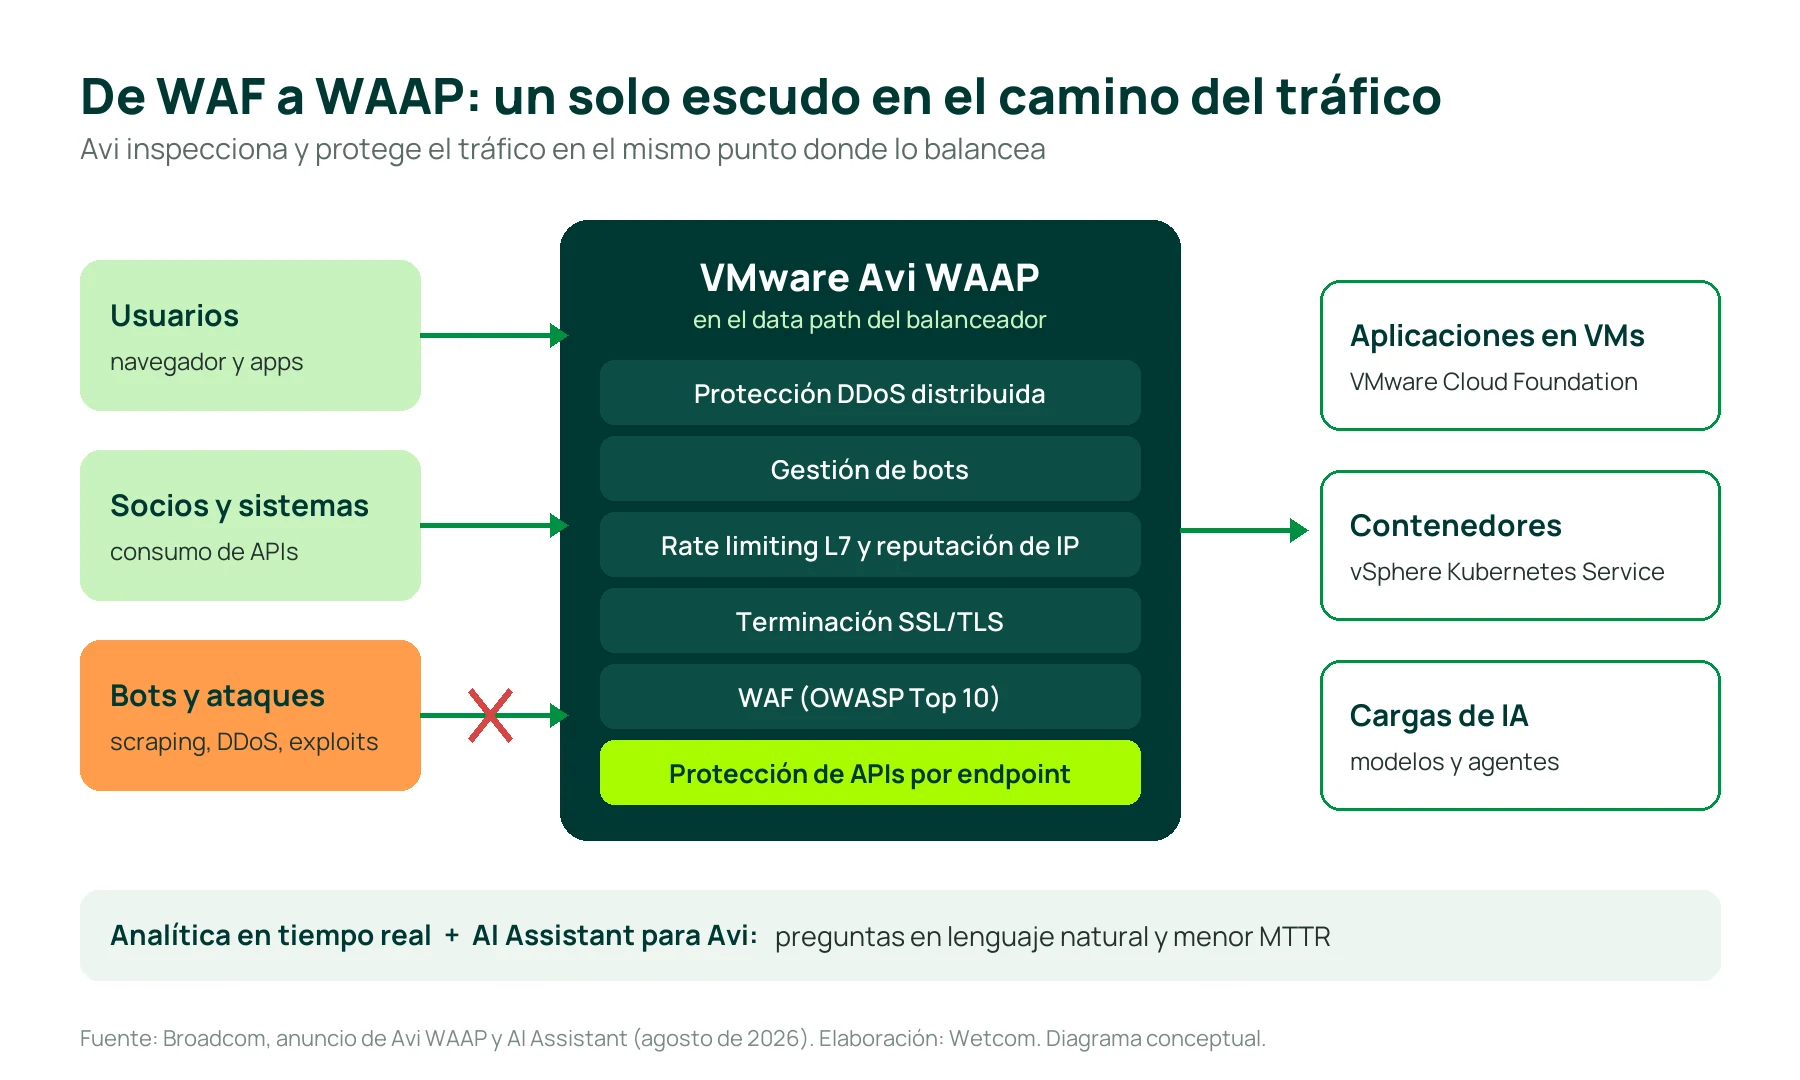
    Un WAAP reúne en una sola capa todo lo que protege a una aplicación expuesta: WAF, protección de APIs, gestión de bots, limitación de tráfico y defensa contra DDoS. La diferencia de Avi es dónde lo hace: dentro del mismo camino del tráfico que ya usa el balanceador. No hay que desviar las conexiones a otro equipo para inspeccionarlas, y la protección escala, se recupera sola y crece junto con las aplicaciones, ya sea que corran en VMs, en contenedores de vSphere Kubernetes Service o como cargas de IA.

    Diagrama de VMware Avi WAAP: el tráfico de usuarios, socios y bots pasa por una sola capa con protección DDoS, gestión de bots, rate limiting, terminación TLS, WAF y protección de APIs antes de llegar a aplicaciones en VMs, contenedores y cargas de IA
    Figura 1. Avi WAAP protege el tráfico en el mismo punto donde lo balancea, para VMs, contenedores y cargas de IA.

    Descubrimiento y clasificación de APIs

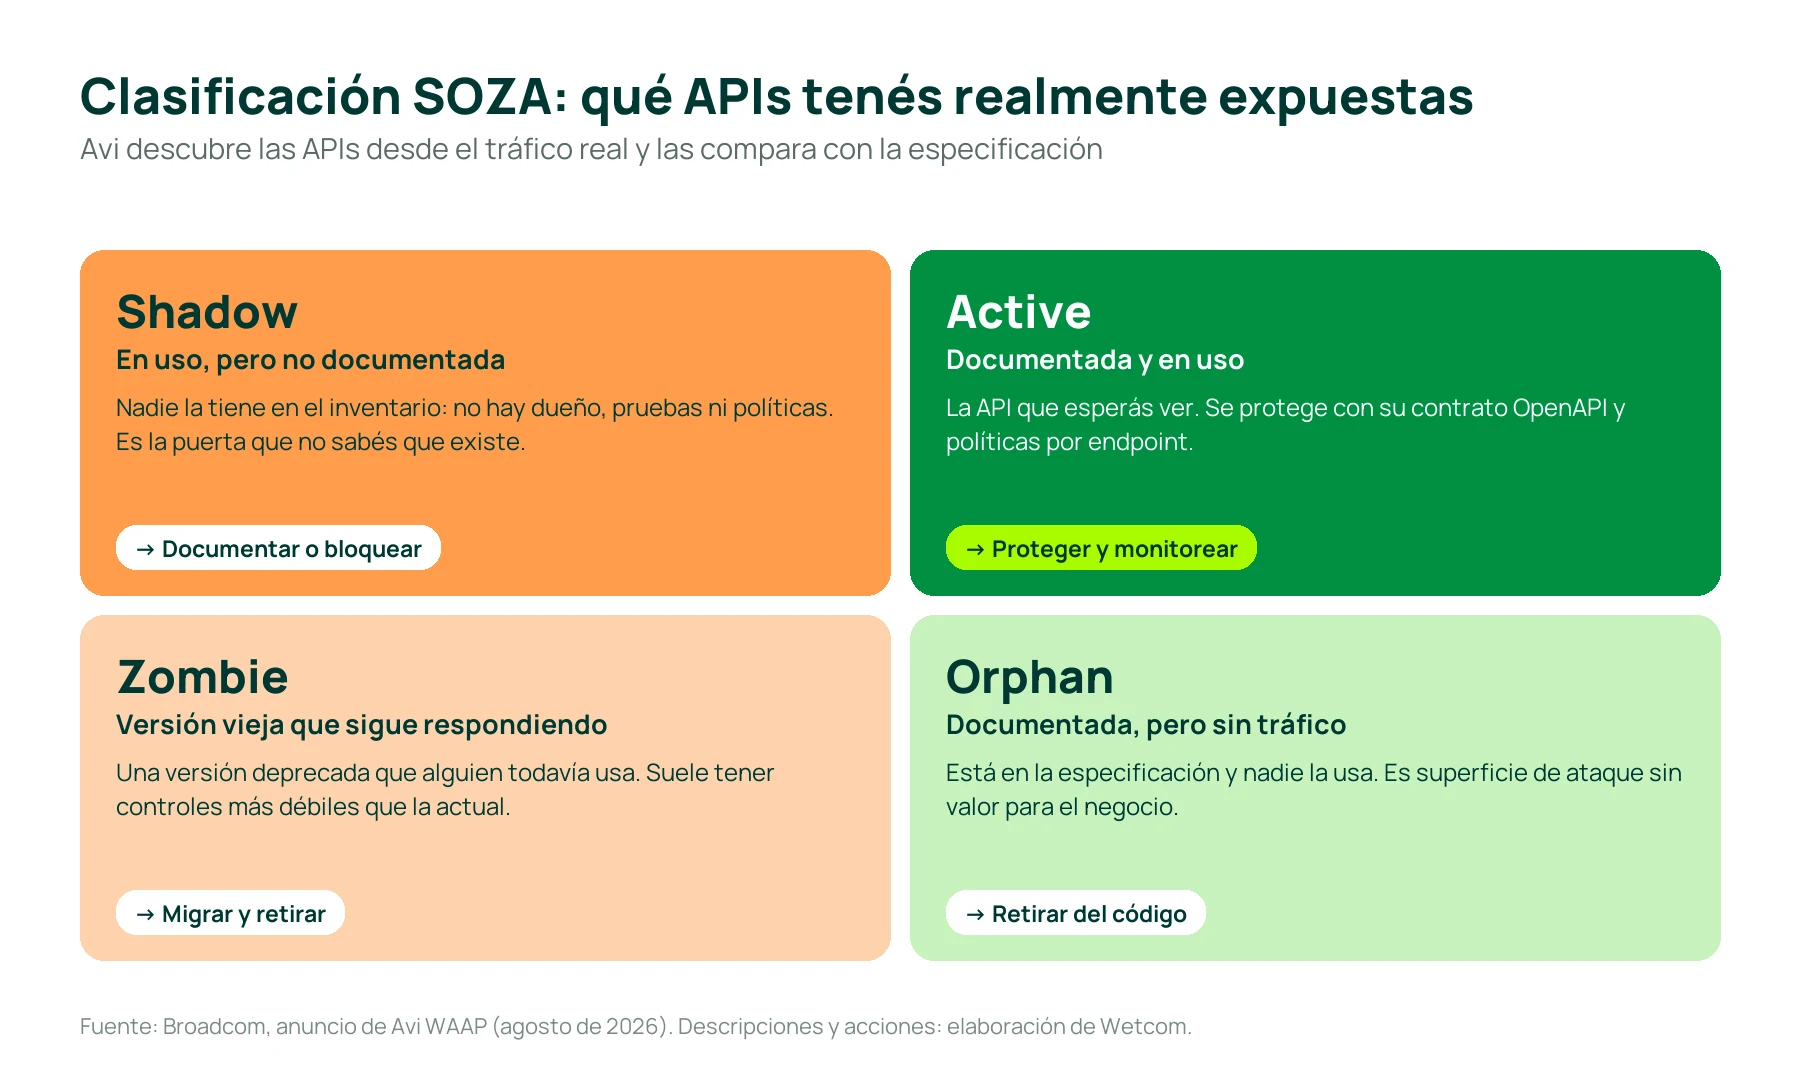
    Como está en el camino del tráfico, Avi descubre con IA y aprendizaje automático todas las APIs que reciben llamadas, sin que los desarrolladores tengan que declararlas. Después las compara con la especificación y clasifica cada endpoint en cuatro grupos, lo que Broadcom llama SOZA:

    Clasificación SOZA de APIs en Avi WAAP: Shadow (en uso pero no documentada), Active (documentada y en uso), Zombie (versión vieja que sigue respondiendo) y Orphan (documentada pero sin tráfico), con la acción recomendada para cada una
    Figura 2. La clasificación SOZA convierte el inventario de APIs en una lista de acciones concretas.

    Para un CISO, esto es lo más valioso del anuncio: pasar de suponer qué está expuesto a verlo con datos del tráfico real, y achicar la superficie de ataque retirando lo que nadie usa antes de que alguien lo explote.

    Políticas por API y contrato OpenAPI

    En lugar de una política general para toda la aplicación, Avi permite aplicar autenticación, rate limiting, reglas de seguridad HTTP y reglas de WAF a cada endpoint por separado. Además, se puede importar la especificación OpenAPI (Swagger) de cada servicio: Avi solo deja pasar las llamadas que respetan las rutas, los métodos y los formatos de datos definidos, y rechaza todo lo demás.

    Protección ante amenazas nuevas

    Avi aprende cuál es el comportamiento normal de cada aplicación y valida el tráfico contra ese modelo en tiempo real. Cuando aparece una amenaza nueva, la plataforma puede responder y escalar sin esperar una firma específica, algo clave cuando los ataques automatizados con IA aparecen en horas.

    AI Assistant para Avi

    Es un asistente conversacional que combina la documentación, las guías y la base de conocimiento de Avi con la analítica en tiempo real de la plataforma. El equipo puede preguntar, por ejemplo, “¿por qué el servicio de e-commerce tiene latencia alta?” y recibir un diagnóstico, en lugar de cruzar logs a mano durante horas. El objetivo es bajar el tiempo de resolución (MTTR) y que el conocimiento no dependa de una o dos personas.

    Más rendimiento con la misma plataforma

    Broadcom informa que el throughput escalable llega a 12,25 Tbps por instancia de controlador, un 88 % más que antes, y que la mejora llega con una actualización de software, sin cambiar hardware.

    Qué significa para el CIO y para el CISO

    TemaPara el CIOPara el CISO
    RiesgoMenos exposición del negocio por APIs que nadie controla.Inventario real de APIs y una superficie de ataque medible.
    CostosUna sola plataforma en lugar de appliances separados de balanceo y WAF.Menos herramientas que integrar, mantener y auditar.
    CumplimientoEvidencia para auditorías y menos hallazgos repetidos.PCI DSS exige proteger las aplicaciones web expuestas con una solución automatizada como un WAF.
    OperaciónMenos tiempo de diagnóstico y menos dependencia de especialistas.Políticas consistentes en VMs, contenedores y cargas de IA.
    VelocidadLos equipos publican APIs nuevas sin frenar el negocio.Cada API nueva hereda controles desde el primer día.

    Cómo se complementa con los servicios de Wetcom

    Avi es la herramienta. El resultado depende de implementarla bien y de operarla todos los días: ajustar reglas, atender falsos positivos y revisar qué APIs aparecen. Así lo trabajamos con nuestros clientes:

    1. Descubrir. Activamos Avi en modo evaluación para relevar las aplicaciones y APIs que reciben tráfico, sin bloquear nada todavía, y te entregamos el mapa SOZA de tu entorno.
    2. Ordenar. Junto con tus equipos de desarrollo, documentamos las APIs shadow, planificamos el retiro de las zombie y las orphan, e importamos los contratos OpenAPI.
    3. Proteger. Pasamos a modo de bloqueo de forma gradual, con políticas por endpoint, gestión de bots y rate limiting, sobre VMware Cloud Foundation y vSphere Kubernetes Service.
    4. Operar. Con nuestro servicio de Networking & Security monitoreamos 7×24, ajustamos reglas, atendemos alertas y te enviamos reportes de salud y amenazas. Ante un incidente crítico, Insane Support escala directo con Broadcom.

    Avi WAAP es una capa más de una estrategia de defensa en profundidad. La completamos con vDefend para frenar el movimiento lateral dentro del datacenter, con VMware HyperArmor para proteger el propio hipervisor y con nuestro servicio de Ransomware Incident Response por si algo igual sale mal. Como Partner Pinnacle de Broadcom, también te ayudamos a dimensionar y contratar las licencias que realmente necesitás.

    ¿Sabés cuántas APIs tenés expuestas hoy? Pedí un relevamiento con nuestros especialistas y te mostramos el mapa real de tus aplicaciones.

    Preguntas frecuentes

    ¿WAAP reemplaza al WAF?

    No: lo incluye y lo amplía. El WAF sigue protegiendo contra los ataques web del OWASP Top 10, y WAAP suma descubrimiento y protección de APIs, gestión de bots, rate limiting y defensa contra DDoS en la misma plataforma.

    ¿Sirve si mis aplicaciones corren en Kubernetes?

    Sí. Según Broadcom, Avi WAAP protege aplicaciones en VMs, en vSphere Kubernetes Service y cargas de IA, y desde VCF 9.1 Avi se integra con las VPC de autoservicio y se automatiza con VKS.

    ¿Tengo que cambiar mi arquitectura de red?

    Si ya usás Avi como balanceador, la protección se suma en el mismo camino del tráfico. Si usás otro balanceador o un WAF en appliance, planificamos la migración por etapas para no afectar el servicio.

    ¿Cómo se contrata?

    Avi Load Balancer se contrata como complemento de VMware Cloud Foundation. Broadcom no detalló en el anuncio las condiciones comerciales de las nuevas funciones, así que conviene validarlas para tu caso: consultanos y te armamos la propuesta.

    Fuentes

    Lecturas relacionadas

  • VMware HyperArmor: protección activa para el hipervisor ESX

    VMware HyperArmor: protección activa para el hipervisor ESX

    El 13 de octubre, Broadcom anunció VMware HyperArmor, una nueva capa de seguridad que trabaja dentro del propio hipervisor ESX de VMware Cloud Foundation (VCF) y de VMware vSphere Foundation (VVF). Viene a cubrir dos huecos que el parcheo y el hardening no alcanzan a cerrar: el tiempo que pasa entre que se publica una vulnerabilidad y se aplica el parche, y el acceso a los hosts con credenciales robadas. Según Broadcom, va a estar disponible próximamente.

    En resumen

    • HyperArmor protege el host ESX, no las VMs: no instala agentes dentro de los sistemas operativos invitados.
    • Hace tres cosas: virtual patching en el hipervisor, bloqueo de cualquier proceso que no sea conocido y MFA para el acceso por SSH.
    • Complementa a vDefend en la red y a VMware Live Recovery en la recuperación. No reemplaza el parcheo.

    Por qué el hipervisor está en la mira

    Atacar un hipervisor rinde más que atacar una VM: quien toma el control de un host ESX controla todas las máquinas virtuales que corren encima. Por eso varios grupos de ransomware tienen versiones pensadas para cifrar datastores de ESXi, y campañas como ESXiArgs, en 2023, llegaron a miles de servidores expuestos.

    A eso se suma la velocidad. Broadcom cita datos de la Cloud Security Alliance: en 2022 pasaban en promedio 32 días entre la publicación de una vulnerabilidad y su explotación; en 2023, 5 días. Con herramientas de IA que encuentran fallas y arman exploits de forma automatizada, hoy ese plazo se mide en horas.

    Los dos huecos que quedan abiertos

    VCF ya trae mucho resuelto: configuración endurecida, cifrado, identidad centralizada y live patching, que permite aplicar parches en ESX sin mover las VMs ni poner el host en mantenimiento. Aun así, quedan dos frentes:

    1. El tiempo entre el aviso y el parche. Para aplicar un parche, primero tiene que existir, y después hay que probarlo y desplegarlo en producción. Si el exploit aparece en horas, ese intervalo deja al host expuesto.
    2. Las credenciales robadas. Con una contraseña de administrador válida, un atacante entra por SSH y ejecuta comandos sin explotar ninguna falla. Ningún parche resuelve eso: es un problema de identidad.

    Qué hace VMware HyperArmor

    1. Virtual patching en el hipervisor

    HyperArmor intercepta en tiempo real las acciones maliciosas durante la ejecución de procesos en el host y bloquea la explotación de vulnerabilidades críticas antes de que exista el parche oficial. No hace falta reiniciar el host ni frenar las cargas. El parche se sigue aplicando, pero con tiempo para probarlo.

    2. Solo corre lo que tiene que correr

    Un host ESX ejecuta un conjunto chico y predecible de procesos. HyperArmor parte de esa base conocida, lo que Broadcom llama seguridad positiva, y bloquea cualquier ejecutable, script o escritura de archivos que no esté autorizado. Como trabaja en la capa de infraestructura, no necesita agentes dentro de las VMs y, según el fabricante, el impacto en el rendimiento es mínimo.

    3. MFA para el acceso por SSH

    El acceso por SSH a ESX pasa a pedir dos pasos: las credenciales habituales y un código temporal (TOTP) asociado a una identidad definida aparte. Aunque alguien consiga la contraseña de un host por phishing o por una filtración, no llega a la línea de comandos sin ese segundo factor.

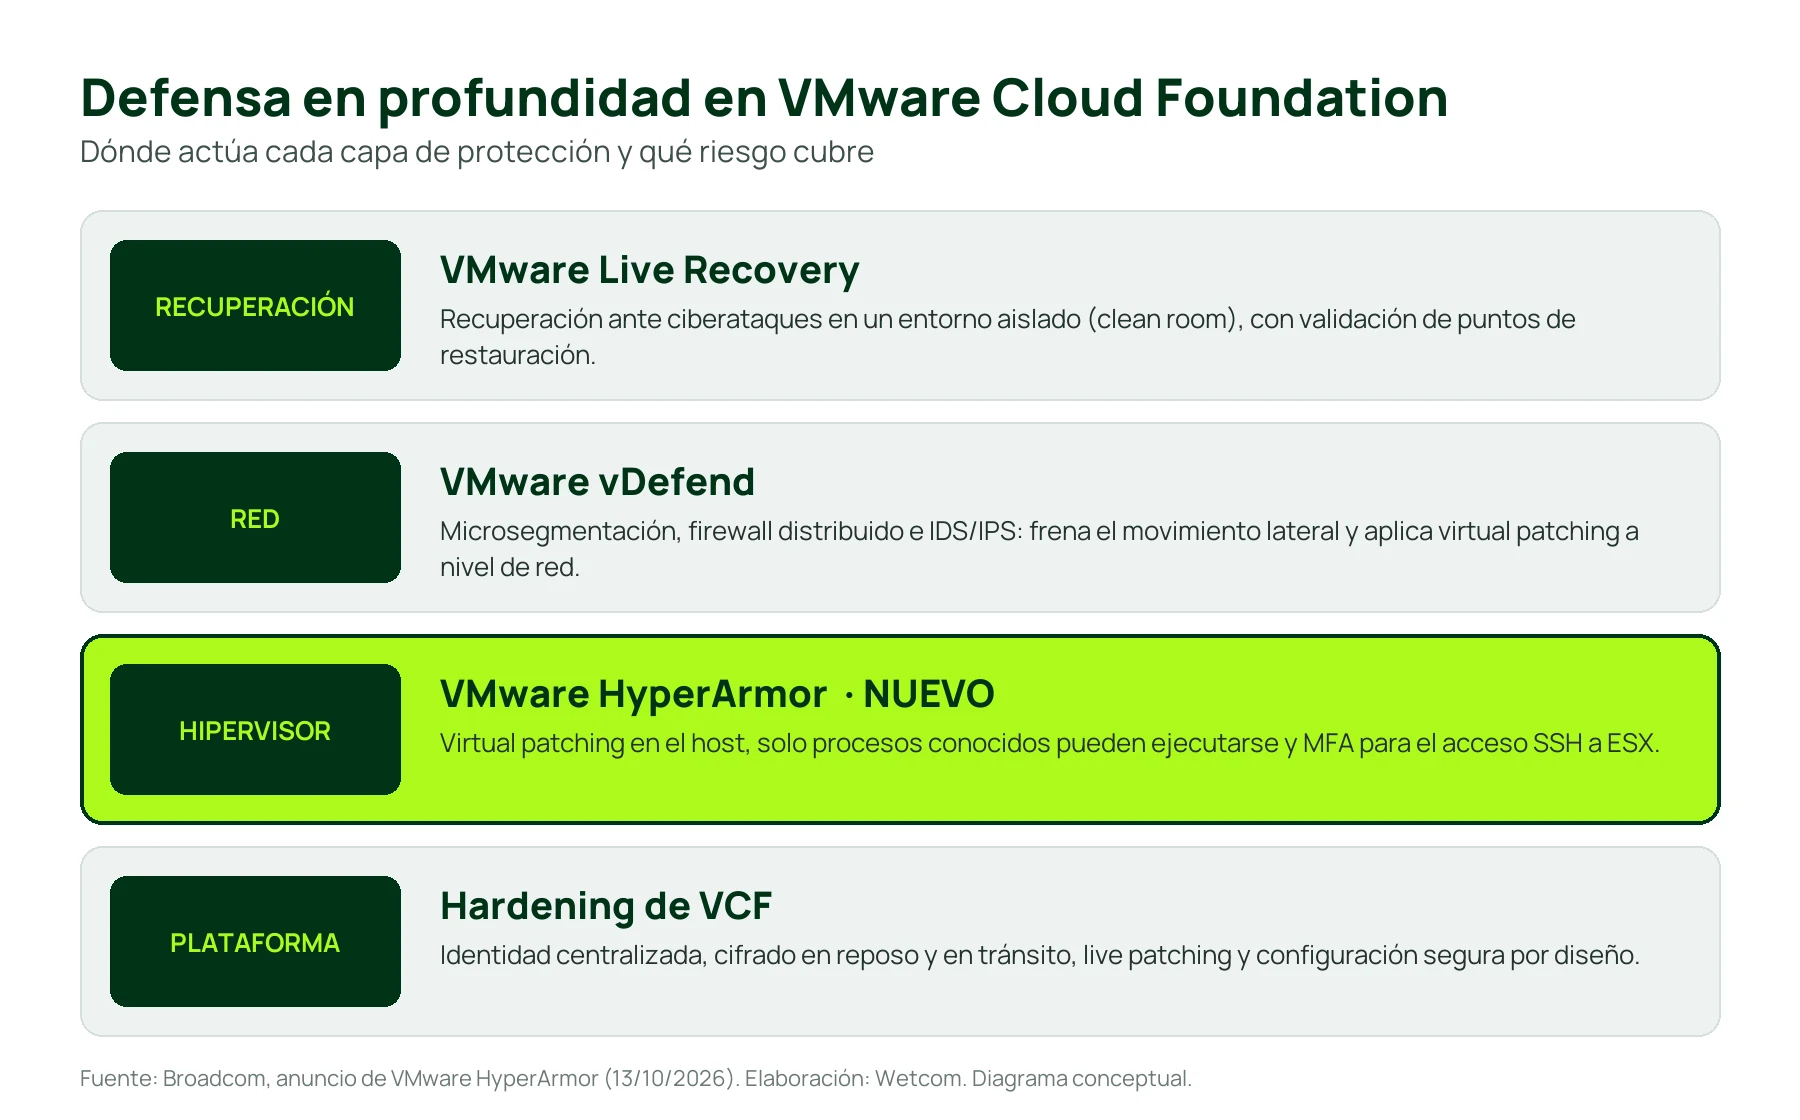
    Diagrama de defensa en profundidad en VMware Cloud Foundation: hardening de la plataforma, VMware HyperArmor en el hipervisor, vDefend en la red y VMware Live Recovery para la recuperación
    Cada capa de seguridad de VCF cubre un riesgo distinto. HyperArmor suma la protección del propio hipervisor.

    Dónde encaja en la seguridad de VCF

    CapaSoluciónQué cubre
    PlataformaHardening de VCFIdentidad centralizada, cifrado en reposo y en tránsito, live patching.
    HipervisorVMware HyperArmorExplotación de vulnerabilidades en ESX, procesos no autorizados y acceso con credenciales robadas.
    RedVMware vDefendMicrosegmentación, firewall distribuido, IDS/IPS y virtual patching a nivel de red.
    RecuperaciónVMware Live RecoveryRecuperación ante ciberataques en un entorno aislado, con validación de los puntos de restauración.

    La idea es que un atacante encuentre una barrera en cada capa. Si ya trabajás la microsegmentación con vDefend, HyperArmor cubre lo que vDefend no ve: lo que pasa dentro del propio hipervisor.

    Qué podés hacer hoy

    HyperArmor todavía no está disponible de forma general y Broadcom aún no publicó los detalles de licenciamiento. Mientras tanto, hay trabajo que podés adelantar en tus hosts ESX:

    • Revisar quién tiene acceso SSH a los hosts y mantenerlo deshabilitado cuando no se usa.
    • Medir cuánto tardás hoy en aplicar un parche crítico de ESX, desde el aviso hasta producción.
    • Confirmar que la red de gestión de los hosts esté separada de las redes de usuarios y no sea accesible desde Internet.
    • Validar que tus backups sean inmutables y que la recuperación esté probada.

    Cómo te ayudamos en Wetcom

    Como Pinnacle Partner de Broadcom, te ayudamos a evaluar la exposición de tus hosts ESX, aplicar el hardening de VCF y planificar la adopción de HyperArmor cuando esté disponible, junto con la microsegmentación de vDefend. Si preferís delegar la operación, nuestro servicio de Networking & Security se ocupa 7×24.

    ¿Querés saber qué tan expuestos están tus hosts ESX? Pedí una revisión con nuestros especialistas.

    Preguntas frecuentes

    ¿HyperArmor reemplaza el parcheo de ESX?

    No. Bloquea la explotación mientras el parche no está aplicado, pero el parche se sigue instalando. Lo que cambia es la urgencia: podés probarlo y desplegarlo en una ventana planificada.

    ¿Hay que instalar agentes en las VMs?

    No. HyperArmor protege el host ESX desde la capa de infraestructura y no requiere agentes en los sistemas operativos invitados.

    ¿Con qué productos funciona?

    Broadcom lo presenta para VMware Cloud Foundation y VMware vSphere Foundation.

    ¿Cuándo va a estar disponible?

    Broadcom lo anunció el 13 de octubre de 2026 como disponible próximamente. Apenas haya fecha y condiciones comerciales, lo vas a ver en este blog.

    Fuentes

    Lecturas relacionadas

  • Memory Tiering en VCF: La Clave Oculta del Rendimiento y el Almacenamiento NVMe

    Memory Tiering en VCF: La Clave Oculta del Rendimiento y el Almacenamiento NVMe

    Cómo elegir el disco adecuado para el Memory Tiering de VCF 

    Si vienen siguiendo las novedades que compartimos desde Wetcom, sabrán que nos apasiona encontrar formas inteligentes de optimizar la infraestructura empresarial, garantizando máxima disponibilidad, rendimiento y previsibilidad financiera.

    Hoy quiero hablarles de una funcionalidad que marca un punto de inflexión en el diseño de centros de datos modernos: el Memory Tiering en VMware Cloud Foundation (VCF).

    El Memory Tiering nos permite extender la memoria del sistema utilizando unidades NVMe SSD de alta velocidad. Esto se traduce en una ventaja estratégica enorme: podemos ejecutar cargas de trabajo más demandantes y consolidar un mayor número de máquinas virtuales sin la necesidad de invertir constantemente en memoria DRAM adicional. La propuesta de valor es clara: mejor uso de los recursos, optimización de costos y escalabilidad a demanda con niveles de latencia consistentemente bajos.

    Sin embargo, para capturar realmente este valor existe una decisión de arquitectura fundamental: la selección adecuada del disco NVMe. Les comparto los detalles para tener en cuenta.


    La trampa del rendimiento inicial: Read-Intensive vs. Mixed-Use

    Al momento de dimensionar un servidor para Memory Tiering, es común comparar las hojas de datos de dos SSDs NVMe empresariales del mismo fabricante. A simple vista, ambos pueden pertenecer a la misma «clase de rendimiento», prometiendo velocidades de lectura secuencial de 7,000 MB/s y picos que superan el millón de IOPS en escritura aleatoria. La única diferencia aparente es la etiqueta: uno es Read-Intensive (RI) y el otro Mixed-Use (MU).

    Es fácil asumir que, al compartir componentes clave y cifras máximas de catálogo, tendrán un comportamiento idéntico bajo cargas operativas, y que la tasa de resistencia (Endurance) solo define su vida útil en años.

    En la práctica, esto no es así. Cuando sometemos ambos discos a pruebas de rendimiento sostenido en el tiempo, los resultados son totalmente opuestos.

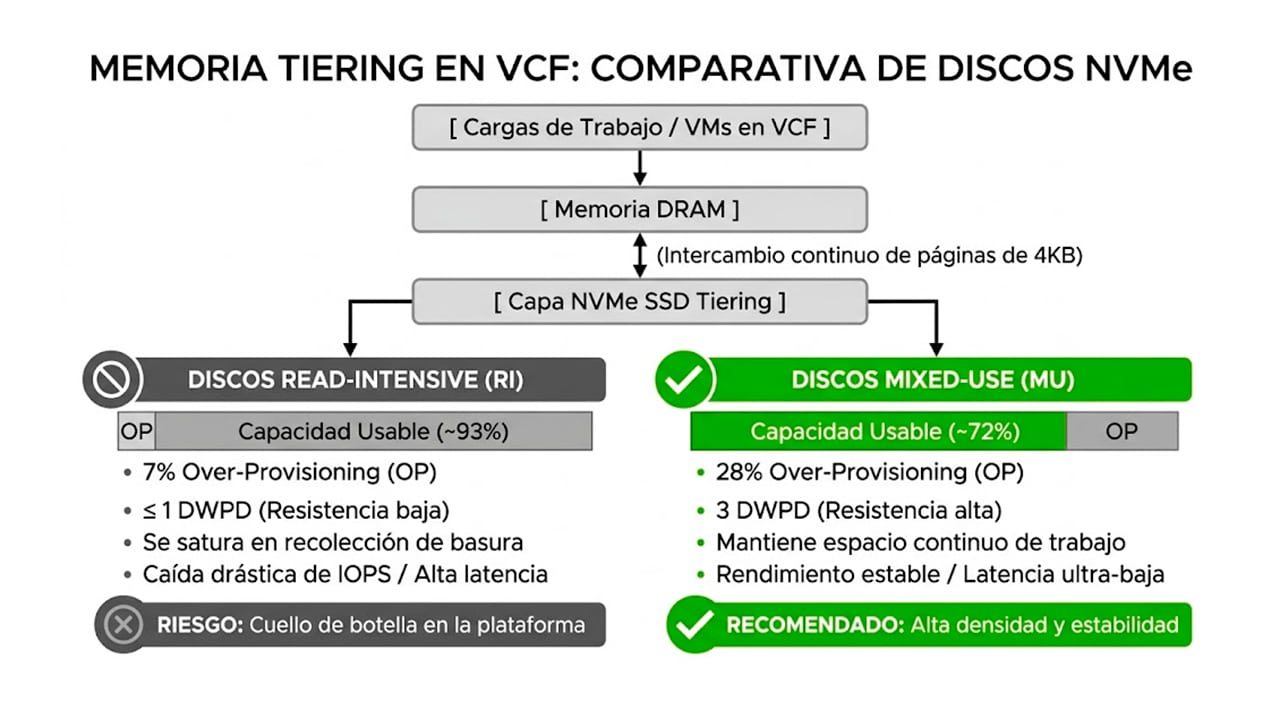
    • Discos Read-Intensive (RI): Diseñados típicamente para 1 DWPD (Drive Writes Per Day) o menos. Su uso ideal está en volúmenes de arranque, caché de lectura y servidores web.
    • Discos Mixed-Use (MU): Calificados habitualmente para 3 DWPD. Están construidos para virtualización, bases de datos OLTP y cargas mixtas de alta intensidad.

    El factor clave: El Sobreaprovisionamiento (Over-Provisioning)

    Cuando se prueba un disco nuevo recién sacado de la caja (Fresh Out of Box), los bloques de memoria NAND están limpios y el controlador escribe a la máxima velocidad del bus PCIe. Sin embargo, en entornos empresariales lo que importa es la maratón, no el sprint.

    En operación continua, las unidades alcanzan el estado estable (Steady State), donde el disco se encuentra lleno. En este punto, la memoria flash no puede sobrescribir datos directamente: debe leer un bloque en memoria, borrar el bloque físico y escribir los nuevos datos. Este proceso se conoce como Garbage Collection (recolección de basura).

    Para gestionar esto de forma eficiente sin impactar la aplicación, los fabricantes reservan un porcentaje de la capacidad del disco para uso exclusivo del controlador. A esto se lo denomina Over-Provisioning (OP):

    • Los discos RI ofrecen aproximadamente un 7% de Over-Provisioning.
    • Los discos MU cuentan con cerca de un 28% de Over-Provisioning.

    Ese espacio de trabajo adicional es el que permite al controlador del disco MU reorganizar la información en segundo plano sin interrumpir las operaciones de escritura que envía el hipervisor.


    Por qué Memory Tiering requiere discos Mixed-Use

    El patrón de acceso de Memory Tiering en VCF es intensivo en escrituras y altamente aleatorio. El sistema traslada constantemente pequeñas páginas de memoria de 4 KB entre la DRAM y el almacenamiento NVMe.

    Si elegimos una unidad RI basándonos solo en los picos de rendimiento teóricos, la infraestructura sufrirá una caída severa cuando el disco entre en estado estable. Al contar con solo un 7% de Over-Provisioning, el controlador se ve obligado a pausar las escrituras del host para liberar espacio. Los IOPS caen abruptamente y la latencia se dispara.

    Por el contrario, la unidad MU, respaldada por su 28% de OP, mantiene un piso de rendimiento estable, predecible y de ultrabaja latencia. Esto garantiza que el movimiento de páginas de memoria no genere cuellos de botella en la plataforma.


    Memory Tiering en VCF: La Clave Oculta del Rendimiento y el Almacenamiento NVMe


    Guía práctica: ¿Cómo identificar la unidad correcta?

    Para asegurar una elección correcta en el diseño de su arquitectura, existen dos caminos principales:

    1. Validación formal: Consultar la Guía de Compatibilidad de Broadcom (Broadcom Compatibility Guide) y verificar que las unidades pertenezcan a la clase de rendimiento F o G y clase de resistencia D.
    2. Criterio rápido por capacidad: Los discos Mixed-Use suelen comercializarse en capacidades que son múltiplos de 800 GB (por ejemplo: 800 GB, 1.6 TB, 3.2 TB, 6.4 TB). Si la capacidad del disco sigue esta nomenclatura, es un indicador claro de que se trata de un disco MU de 3 DWPD con el 28% de sobreaprovisionamiento necesario.


    Conclusión

    El Memory Tiering es una tecnología extraordinaria que permite maximizar la densidad de cómputo y optimizar el retorno de inversión en centros de datos definidos por software. Sin embargo, para obtener los beneficios esperados en entornos corporativos, es fundamental acompañarla con la ingeniería de hardware adecuada.

    En Wetcom acompañamos a las organizaciones en el diseño, implementación y optimización de sus arquitecturas sobre VMware Cloud Foundation, asegurando siempre el equilibrio perfecto entre rendimiento, costo y confiabilidad.

  • Cómo optimizar tu infraestructura ante la cuenta regresiva de vSphere 8

    Cómo optimizar tu infraestructura ante la cuenta regresiva de vSphere 8

    Cómo maximizar el rendimiento de tu infraestructura actual, reducir costos operativos y prepararte para el fin de soporte de vSphere 8.


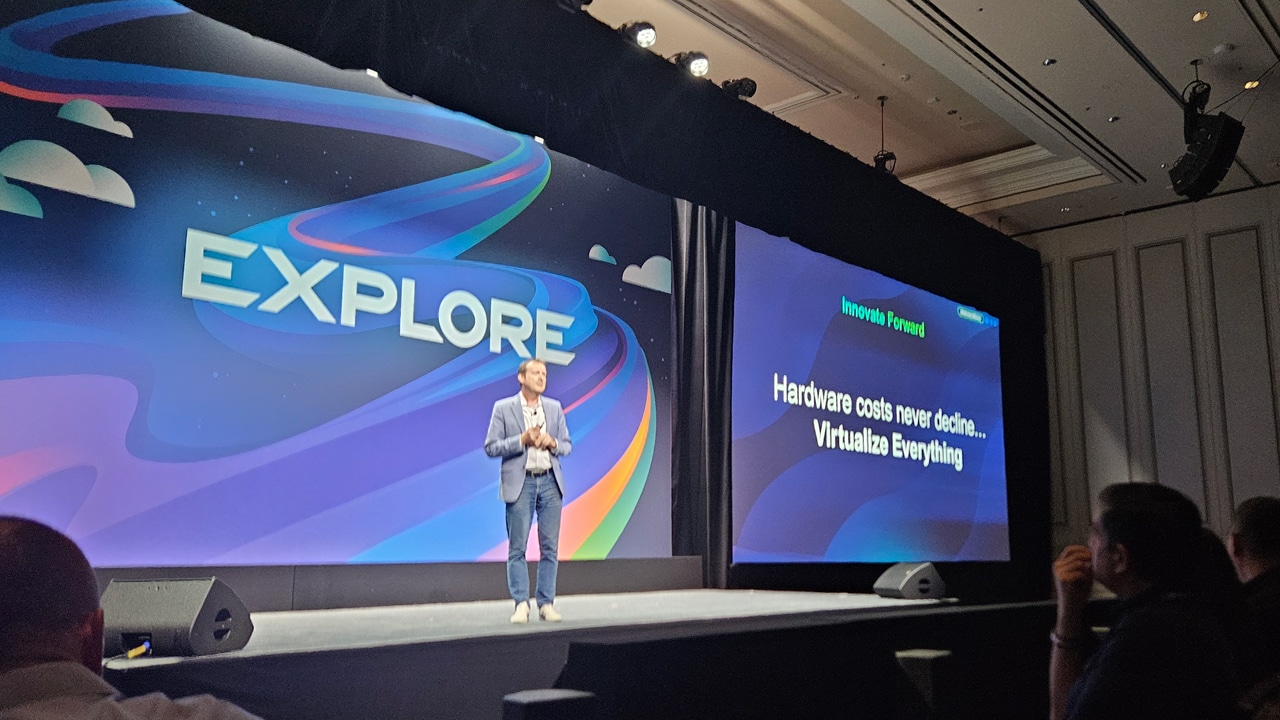
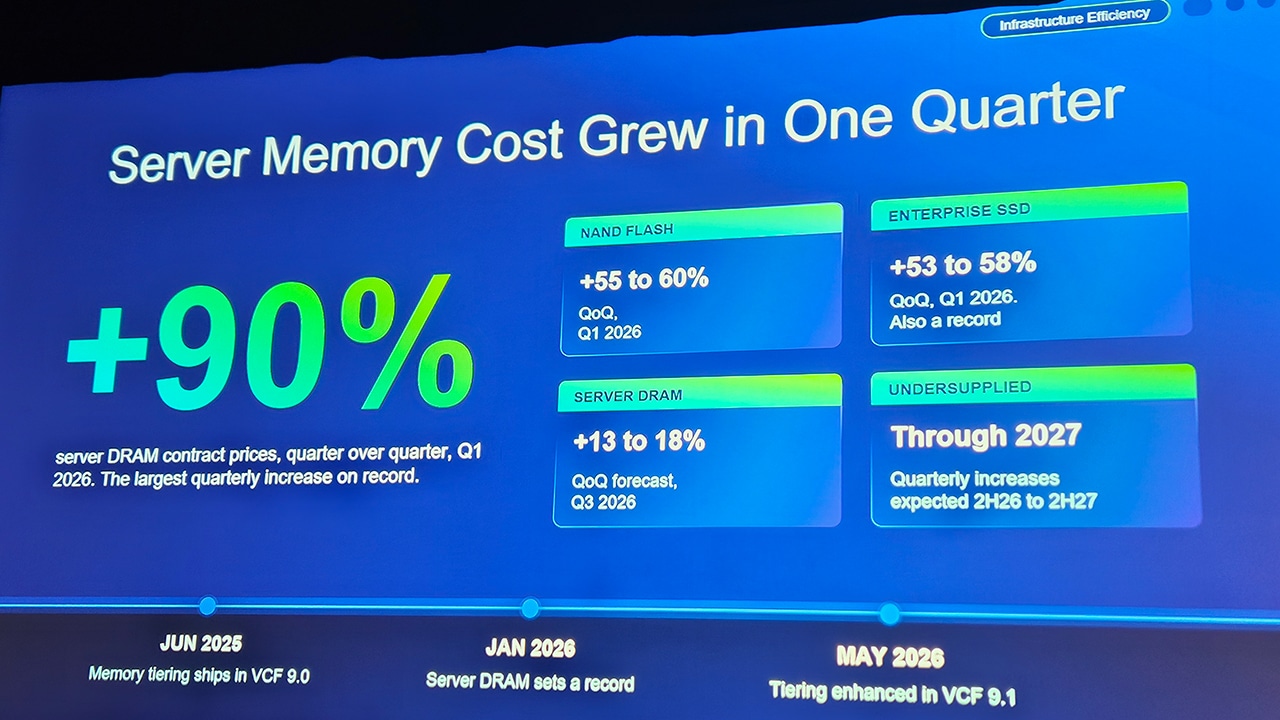
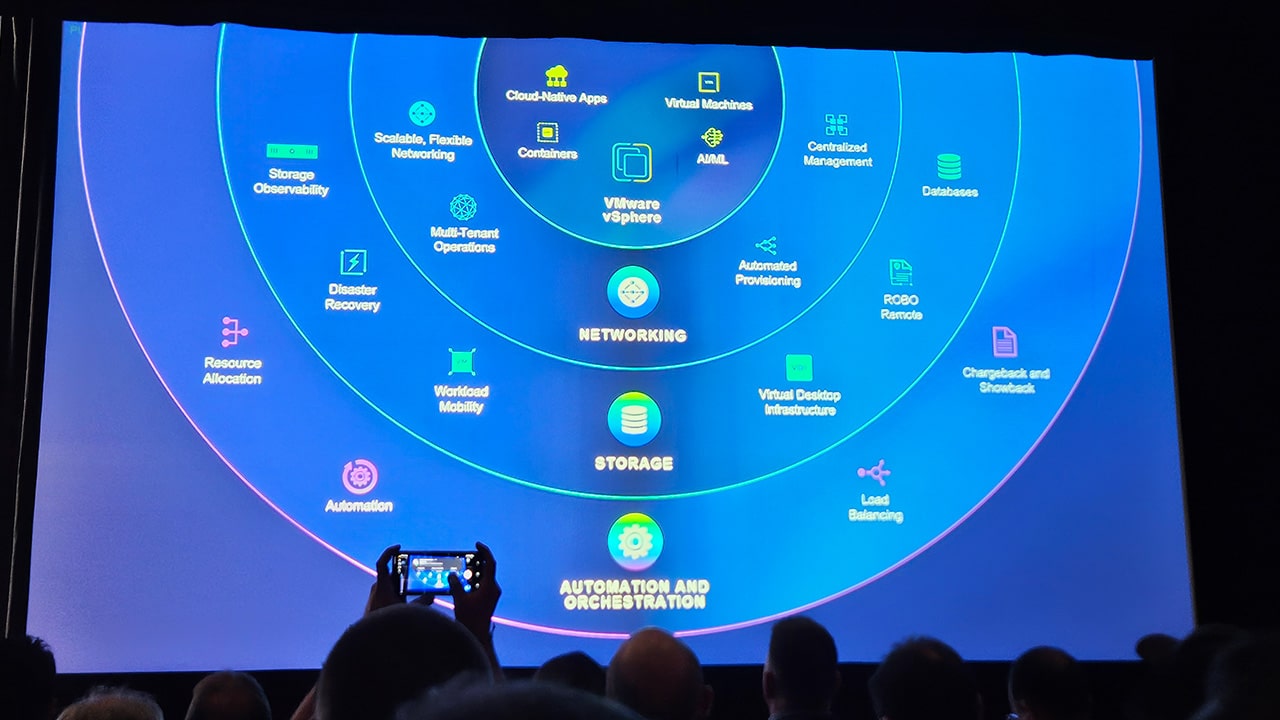
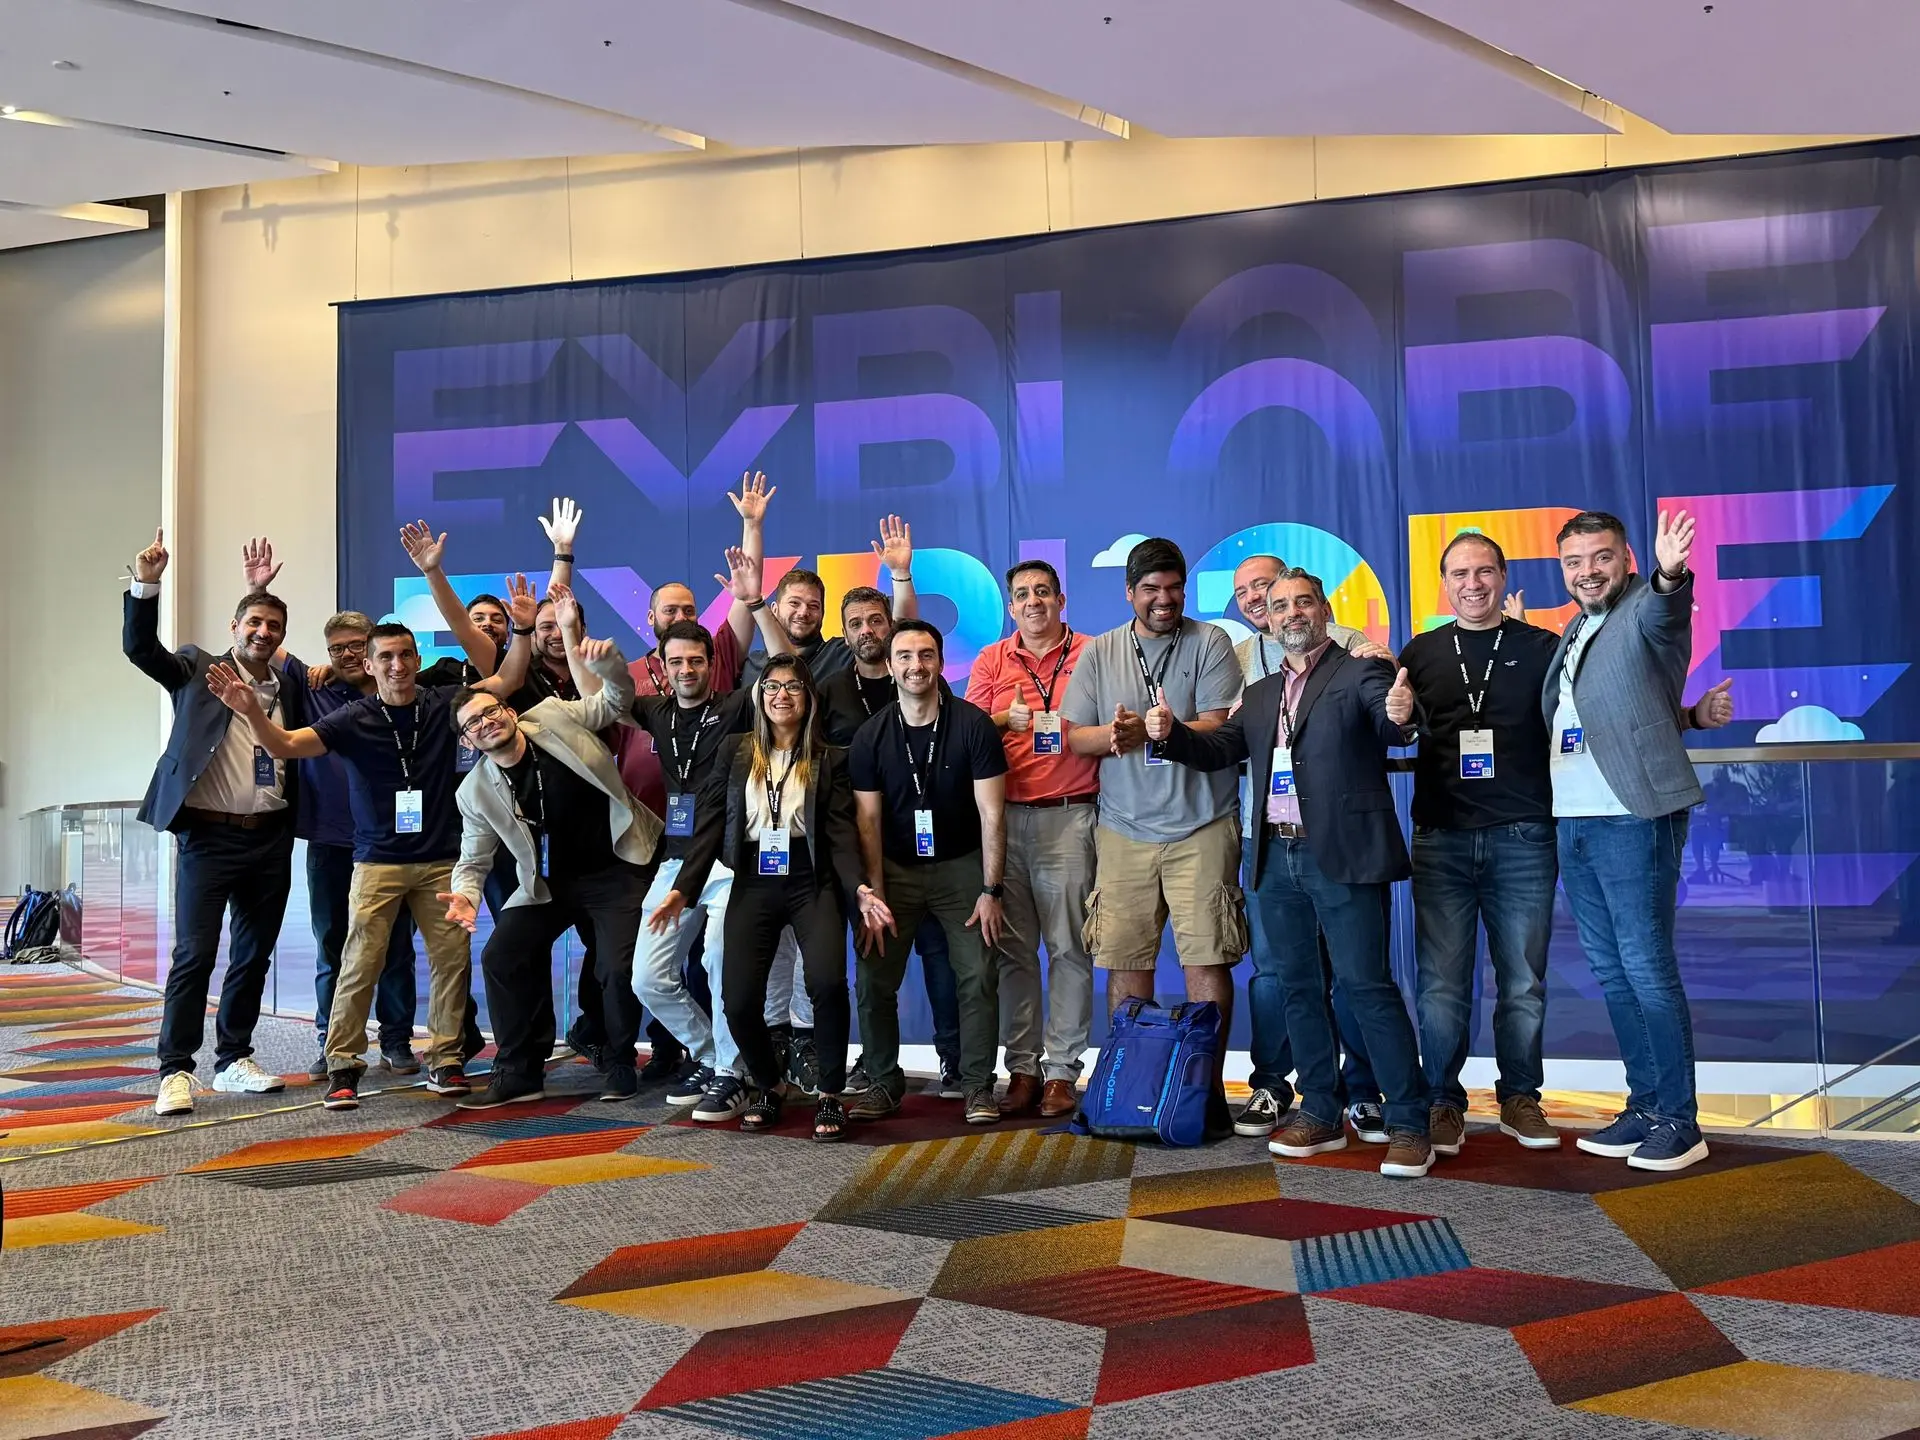
    Durante nuestra participación en VMware Explore 2026 en Las Vegas, el equipo de Wetcom recopiló los anuncios más críticos e innovaciones tecnológicas presentadas directamente por Broadcom. Uno de los mensajes claves que rescatamos es que en el panorama corporativo actual, la eficiencia ya no es una meta deseable; es una necesidad de supervivencia operativa. Con la evolución constante de los Datacenters y las crecientes exigencias de los negocios, optimizar el hardware se ha convertido en la prioridad número uno para los decisores de IT.

    Si a esto le sumamos los plazos de soporte y las nuevas amenazas de seguridad, la urgencia de actuar es clara. En este artículo, desglosamos los 4 pilares clave para optimizar tu hardware hoy mismo y los motores críticos que están impulsando a las empresas a migrar.


    Cómo optimizar tu infraestructura ante la cuenta regresiva de vSphere 8


    Los 4 Pilares de la Optimización de Hardware

    Maximizar el rendimiento de tu infraestructura actual mientras preparas el camino para el futuro es posible gracias a estas innovaciones y estrategias:

    1. Reutilización del Hardware Existente

    No siempre es necesario empezar de cero. La optimización moderna te permite aprovechar tus inversiones previas gracias a una compatibilidad del 90% con servidores que soportan vSphere 8.x. Además, se mantiene el soporte continuo con fabricantes OEM esenciales para arquitecturas Skylake y Cascade Lake. Tu legado tecnológico todavía tiene mucho para dar.

    1. Memory Tiering (Estratificación de Memoria)

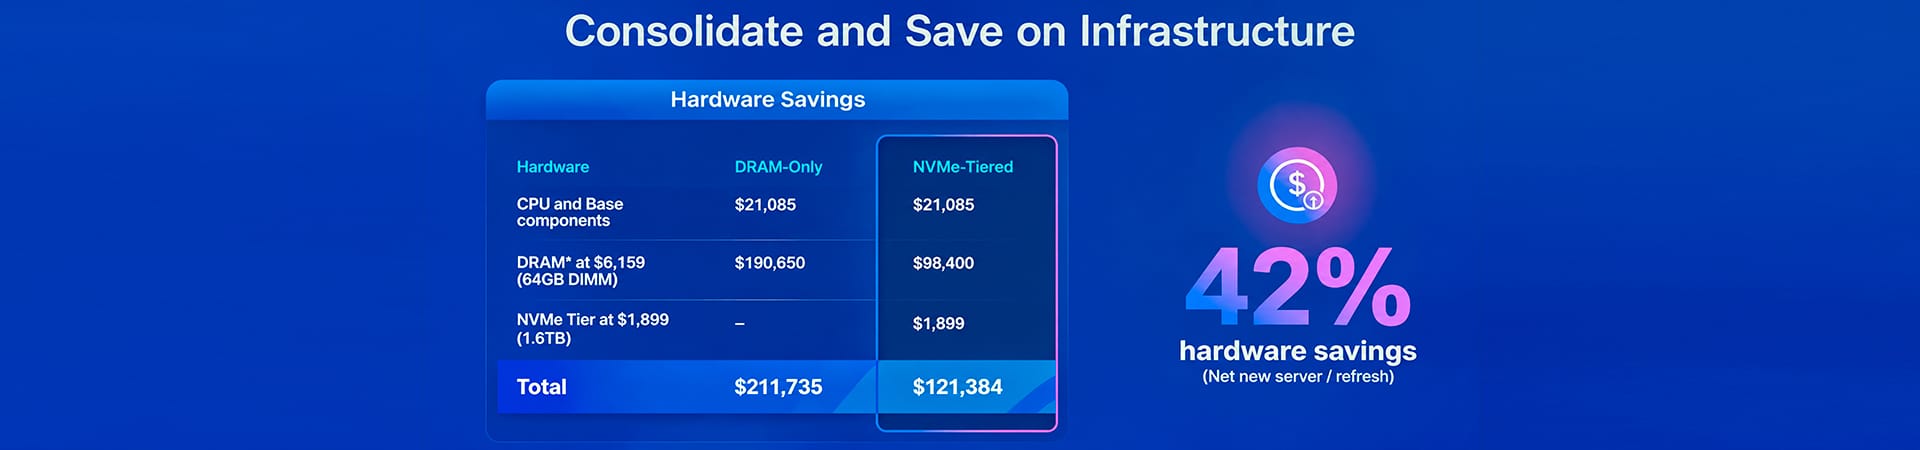
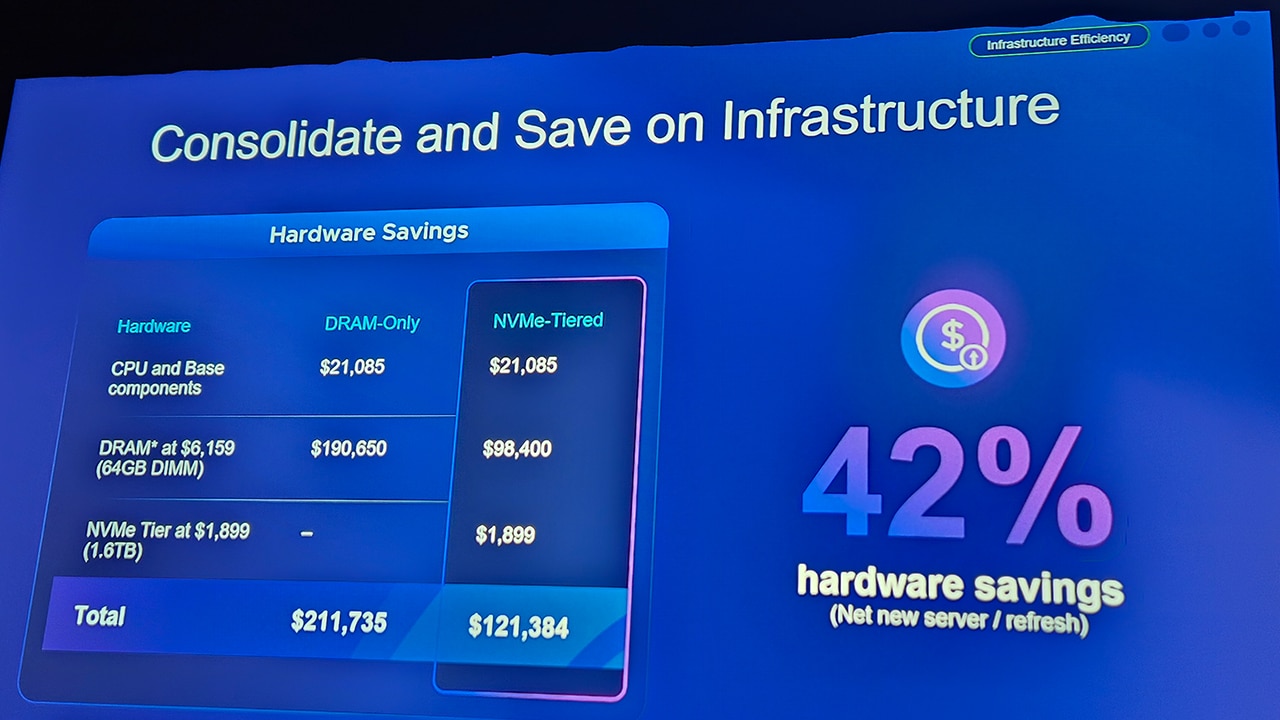
    ¿Cómo equilibrar el rendimiento exigente con los presupuestos ajustados? La respuesta está en el Memory Tiering. Al combinar de forma estratégica DRAM con almacenamiento NVMe local de bajo costo, es posible lograr hasta un 42% de ahorro en la adquisición de memoria, con un impacto imperceptible en el rendimiento (menor al 3%).


    Cómo optimizar tu infraestructura ante la cuenta regresiva de vSphere 8 (imagen 2)


    1. Reducción del Overhead en vSAN ESA

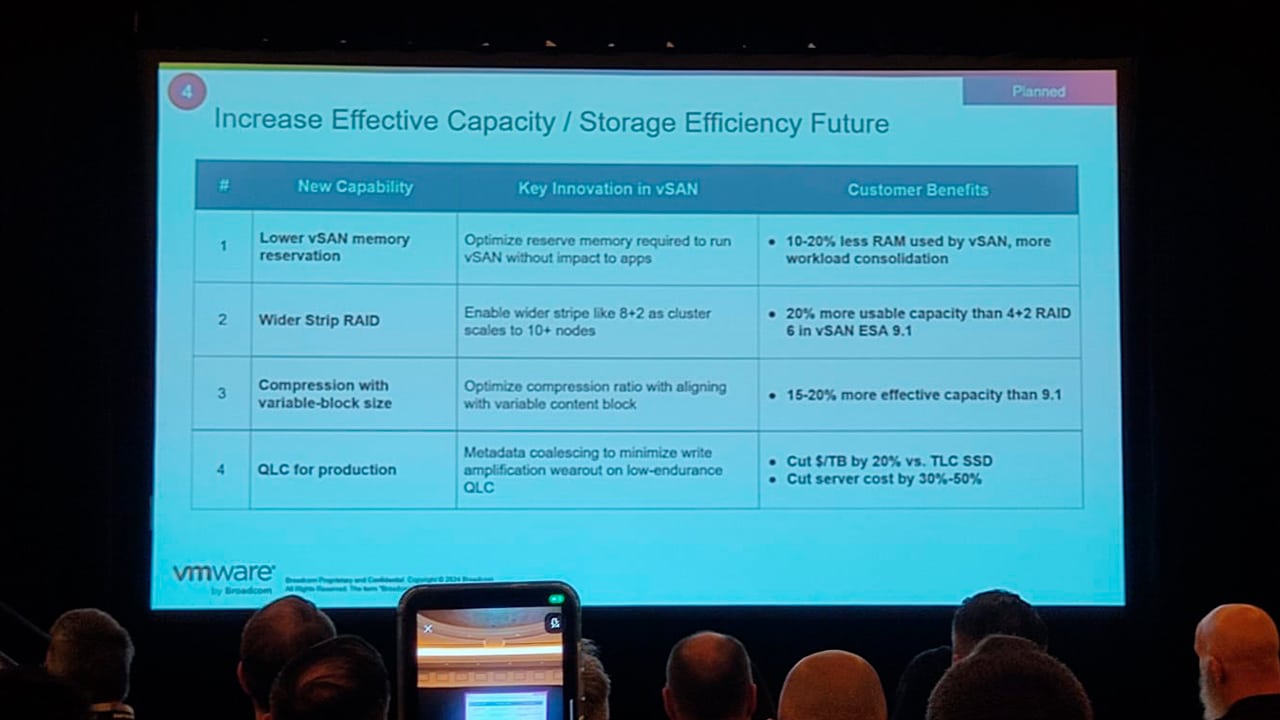
    La arquitectura de almacenamiento moderna es ahora mucho más eficiente. Con la reducción del overhead en vSAN ESA, se logra una disminución de hasta un 67% en el consumo de CPU y RAM. ¿Lo mejor? Se elimina la rígida reserva del 30% del espacio, permitiendo que tu infraestructura opere de forma segura y optimizada entre el 80% y el 90% de su capacidad.

    1. Nuevos Modelos OEM y Almacenamiento Económico

    El ecosistema se abre a opciones más rentables sin sacrificar la confiabilidad. Actualmente, contamos con la certificación de alternativas de menor costo (como Supermicro) y el soporte avanzado para unidades QLC en bases de datos. Todo esto respaldado por mecanismos inteligentes de mitigación para el write amplification, extendiendo la vida útil de tus componentes de almacenamiento.


    Cómo optimizar tu infraestructura ante la cuenta regresiva de vSphere 8 (imagen 3)

    Los Impulsores Críticos: ¿Por qué la migración no puede esperar?

    La optimización de hardware no ocurre en el vacío. Hay dos factores urgentes del mercado que obligan a las organizaciones a acelerar sus planes de actualización:

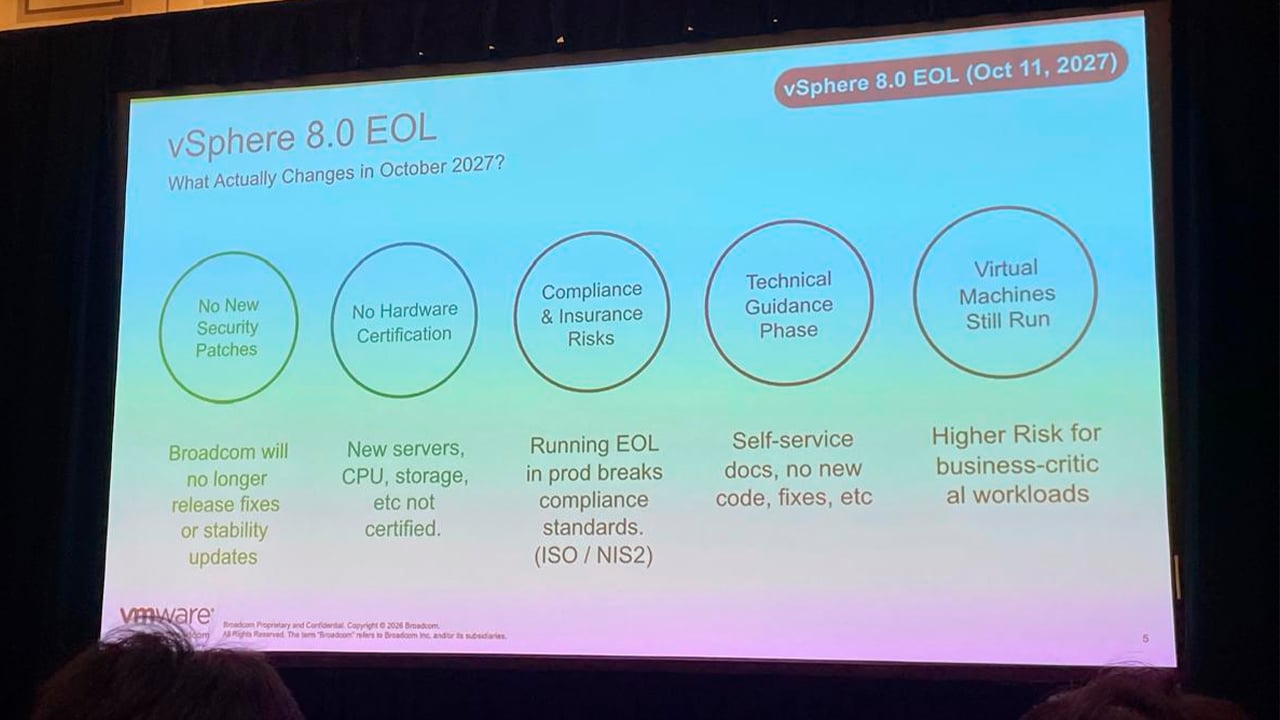
    • Fin de Vida del Software (EOL): El tiempo corre. La fecha límite de soporte para vSphere 8 y VCF 5.2 está fijada para mediados de octubre de 2027. Quedarse atrás significa exponerse a brechas operativas y de cumplimiento.
    • Mitigación de Ciberamenazas Avanzadas: Los atacantes están evolucionando rápido, utilizando modelos de Inteligencia Artificial para diseñar amenazas cada vez más complejas. La única forma de defenderse es operando sobre versiones de plataformas totalmente actualizadas, que cuenten con capacidades unificadas de parcheo agresivo.


    Cómo optimizar tu infraestructura ante la cuenta regresiva de vSphere 8 (imagen 4)

  • Broadcom presenta VMware Private AI Cloud en Explore 2026

    Broadcom presenta VMware Private AI Cloud en Explore 2026

    La era de la Inteligencia Artificial segura, económica y eficiente.

    En el marco de VMware Explore 2026 en Las Vegas, Broadcom ha marcado un hito en la evolución tecnológica empresarial con el lanzamiento de VMware Private AI Cloud. Esta nueva solución representa un cambio de paradigma fundamental: en lugar de llevar los datos hacia los modelos de Inteligencia Artificial, lleva los modelos directamente hacia donde residen los datos.

    A través del portafolio avanzado de infraestructura de nube, aplicaciones y software de seguridad de Broadcom, las organizaciones ahora cuentan con un camino listo para la producción. Esto permite construir, ejecutar y gobernar cargas de trabajo de IA en una única plataforma de nube privada.

    «VMware Private AI Cloud es el punto de inflexión donde la nube privada empresarial y la infraestructura de IA privada dejan de operar como disciplinas separadas y se convierten en una sola», afirmó Ram Velaga, presidente del Infrastructure Software Group en Broadcom.

    A continuación, detallamos los tres pilares de este anuncio y cómo transformarán la estrategia tecnológica de las empresas.


    Broadcom presenta VMware Private AI Cloud en Explore 2026


    1. Escalar la IA de forma costo-efectiva

    El despliegue de la IA tradicionalmente se enfrenta a tres grandes barreras económicas: el gasto de capital (CapEx) en hardware, la complejidad operativa y los costos de los tokens (tokenomics).

    VMware Cloud Foundation (VCF) 9 resuelve estos desafíos mediante:

    • Optimización de almacenamiento: Introducción de la asignación de memoria por niveles NVMe (memory tiering) y la deduplicación de almacenamiento a nivel de clúster para reducir costos de hardware.
    • Soporte heterogéneo: Compatibilidad con GPUs, CPUs y aceleradores de los principales fabricantes del mercado, permitiendo operar clústeres mixtos de manera eficiente.
    • Control de consumo: Herramientas nativas de monitoreo de tokens, uso compartido de modelos multi-tenant y un panel de observabilidad de métricas de IA.


    Broadcom presenta VMware Private AI Cloud en Explore 2026 (imagen 2)


    Innovaciones clave:

    • VMware AI Factory: La base definida por software de VMware Private AI Cloud. Automatiza el despliegue de la infraestructura lista para la IA y las operaciones de «Día 2», acelerando el tiempo de puesta en marcha del primer modelo.
    • Modelos de IA validados para VCF: Los clientes de VCF podrán ejecutar más de 150 modelos comerciales y de código abierto (incluyendo Nemotron 3, Gemma 4, cotomi, Qwen y GLM 5.2) de forma local, garantizando la soberanía de los datos y un modelo de Model-as-a-Service (MaaS) seguro.


    Broadcom presenta VMware Private AI Cloud en Explore 2026 (imagen 3)


    1. Operar con la máxima seguridad (Zero Trust para IA)

    Diseñado bajo un enfoque de defensa en profundidad alineado con el marco NIST CSF 2.0, VCF minimiza la superficie de ataque frente a las amenazas modernas potenciadas por la IA.

    A través de VMware vDefend, la plataforma aplica parches virtuales y seguridad lateral a nivel de hipervisor mediante microsegmentación. Esto permite bloquear exploits y mantener una postura de Zero Trust estricta.

    Innovaciones en seguridad:

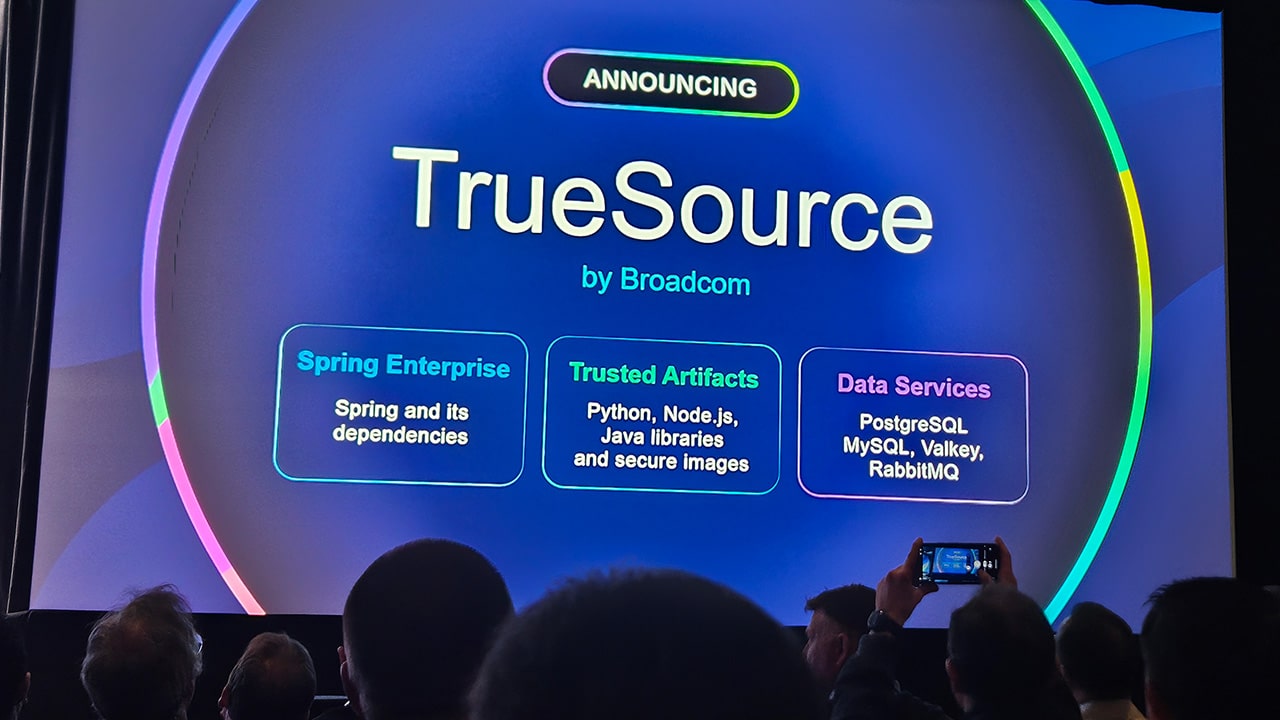
    • TrueSource de Broadcom: Una solución diseñada para combatir el software malicioso impulsado por IA. Ofrece parches verificados por humanos y escaneados con modelos de frontera para el ecosistema Java (Spring Enterprise), Python, Node.js y el catálogo de imágenes seguras de Bitnami. También se extiende a la capa de datos con soporte para PostgreSQL, RabbitMQ, MySQL y Valkey.
    • Agentic Zero Trust con vDefend: Identifica componentes de IA mediante el monitoreo continuo de flujos de tráfico, detecta el uso no autorizado de IA (Shadow AI) y genera firmas automáticas de detección/prevención de intrusiones (IDPS) mediante IA.
    • Defensa contra amenazas con Avi Load Balancer: Restringe el acceso de los agentes a herramientas no autorizadas, aísla comportamientos anómalos (ataques Zero-Day) y evita la filtración de datos sensibles.


    Broadcom presenta VMware Private AI Cloud en Explore 2026 (imagen 4)


    1. Innovación rápida en la era de los agentes de IA

    A diferencia de las aplicaciones tradicionales, los agentes de IA autónomos pueden actuar sin supervisión, exceder su alcance o malinterpretar instrucciones. Para mitigar este riesgo, la combinación de VMware Tanzu Platform y VMware vDefend introduce una arquitectura de «denegación por defecto» (deny-by-default).

    Innovaciones para la era agéntica:

    • AgentMinder de Broadcom: Un nuevo plano de control centralizado que gestiona los agentes de IA autónomos como identidades corporativas. Vincula su autoridad a una misión específica, herramientas aprobadas y recursos autorizados, ofreciendo auditoría de cumplimiento total.
    • Bases de datos listas para la IA: Permite a los propietarios de datos construir canalizaciones (pipelines) dinámicas entre datos estructurados y no estructurados, optimizando el consumo de los agentes a bajo costo sin que la información salga de la empresa.
    • Fundaciones de agentes en Tanzu Platform: Los agentes tienen cero acceso a APIs, redes o internet a menos que se les otorgue explícitamente. Además, un almacén de credenciales aislado evita por completo el robo de credenciales y los ataques de inyección de prompts.


    Broadcom presenta VMware Private AI Cloud en Explore 2026 (imagen 5)


    Durante el cierre de la Plenary Session, Broadcom anunció formalmente que el evento VMware Explore cambiará de fechas y se celebrará del 3 al 6 de mayo de 2027 en el

    complejo Resorts World Las Vegas.


    Broadcom presenta VMware Private AI Cloud en Explore 2026 (imagen 6)


    El próximo paso para tu infraestructura

    Con VMware Private AI Cloud, Broadcom entrega una infraestructura de producción que unifica el rendimiento de la IA con el control, el cumplimiento normativo y la predictibilidad de costos que las empresas modernas exigen.


    En Wetcom, como tus aliados estratégicos en soluciones de VMware y arquitectura de nube, estamos listos para acompañarte en la adopción de estas tecnologías de vanguardia para potenciar tu negocio de forma segura.

  • La estrategia más rápida y segura para modernizar tu infraestructura VMware

    La estrategia más rápida y segura para modernizar tu infraestructura VMware

    El dilema de la nube

    Hace años que la nube promete innovación, pero la realidad del data center suele chocar con la inercia operativa. Esto deja a muchos equipos de IT frente al mismo dilema: migrar rápido con un Lift & Shift o avanzar lentamente hacia la modernización.

    Google Cloud VMware Engine (GCVE) resuelve este conflicto. La migración de cargas VMware on-premise a Google Cloud es un proceso simple, casi equivalente a mover un datacenter VMware hacia otro, pero sobre infraestructura cloud.

    Lo fundamental es entender que GCVE no es el destino final; sino puente estratégico y de bajo riesgo. Permite migrar con urgencia (preservando VMware) mientras habilitamos el camino hacia la modernización (cloud-native).

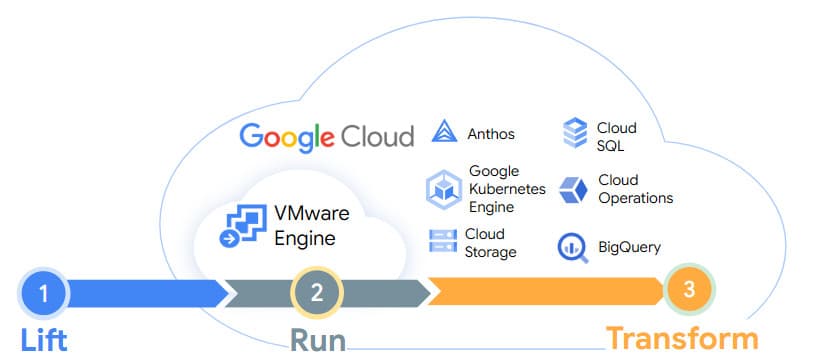
    Hoy el mensaje ya no es solo Lift & Shift: es Lift, Run & Transform.

    Lift, run and transform

    GCVE como Rehost Inteligente y Flexible

    El principal valor de GCVE está en su velocidad y en la reducción del riesgo al migrar entornos VMware hacia Google Cloud. GCVE ejecuta un SDDC completo de VMware (vSphere, vCenter y NSX) de forma nativa en Google Cloud, lo que permite migrar cargas sin re-arquitecturar aplicaciones ni modificar la lógica existente.

    Moverse a GCVE también libera a los equipos de IT de tareas operativas y de bajo valor, como aplicar parches, administrar almacenamiento o mantener servidores físicos. La adopción es gradual y acumulativa: muchos servicios de Google Cloud pueden habilitarse con apenas unos clics, permitiendo que el talento técnico se enfoque en optimizar la arquitectura y en iniciativas que realmente aportan al negocio.

    Actualizar sistemas operativos, gestionar bases de datos o sostener infraestructura física no genera diferenciación. Aterrizar en GCVE acerca a las organizaciones a un modelo donde those cargas operativas se reducen, mientras se aprovechan los servicios de nube con mayor inteligencia para capitalizar todo su potencial.

    La Flexibilidad de los Flex CUDs

    Hablemos de cómo Google acompaña este enfoque de transformación.

    Un temor frecuente al migrar a la nube es quedar atado a contratos rígidos o a tipos de máquinas específicos. Google resuelve este desafío con un modelo mucho más flexible, especialmente valioso durante etapas de transición:

    • Google ofrece Compromisos de Uso Flexible (Flex CUDs), que permiten comprometerse con un monto de gasto en dólares de cómputo, no con una máquina o servicio particular. En GCVE, esta es la única modalidad de CUD disponible, lo que desde el inicio habilita la posibilidad de migrar más adelante hacia otros tipos de workloads sin perder los beneficios del descuento.

    En términos simples: podés comprometerte a gastar una cantidad $X y luego cambiar el tipo o la región de la máquina, incluyendo nodos de GCVE, instancias de GCE, GKE y otros servicios, manteniendo siempre el descuento asociado.

    Este modelo elimina el riesgo de vendor lock-in por hardware o servicio, and habilita una transición fluida hacia otros servicios de cómputo cuando llegue el momento de avanzar en la modernización de tus aplicaciones.

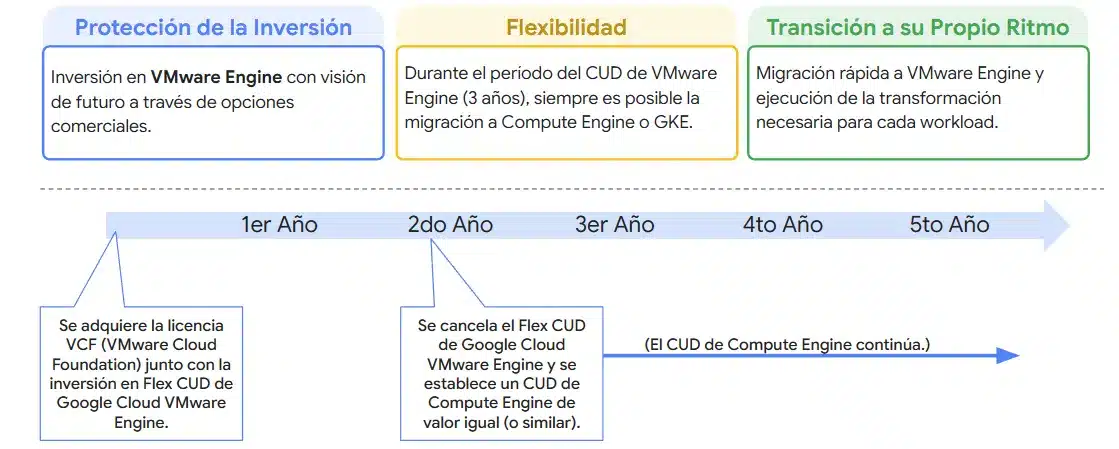
    La ruta con Flex CUDs en GCVE

    Inversión en GCVE

    Siguiendo la captura anterior, tu inversión en los nodos de GCVE queda protegida durante todo el ciclo. Si en el segundo año decidís migrar una carga de VMware hacia Compute Engine (GCE) o GKE, podés cancelar el CUD de GCVE y transferir su valor remanente para establecer un nuevo CUD equivalente en GCE o GKE.

    Esto te permite mantener el descuento, conservar el ahorro y acompañar la evolución de tus workloads, reflejando de manera precisa el enfoque de Lift, Run & Transform.

    Conectividad Nativa: El Primer Paso hacia PaaS

    Como mencioné antes, uno de los errores más comunes es ver GCVE como un silo. Su verdadero valor está en su conectividad nativa de baja latencia con el ecosistema de Google Cloud. Una vez que tu entorno VMware está en GCVE, tus aplicaciones heredadas están literalmente a milímetros de consumir servicios nativos de Google.

    No aprovechar estos servicios nativos representa una pérdida del TCO real de la infraestructura. Por eso es fundamental utilizar el tiempo que GCVE ofrece para ser estratégicos con cada aplicación y planificar qué workloads pueden modernizarse sin disrupción.

    Desde Wetcom hacemos especial foco en identificar el consumo base para dimensionar Flex CUDs con precisión, asegurando ahorro en todo el cómputo y habilitando una transición ordenada hacia otros servicios cuando tenga sentido.

    Algunos ejemplos de caminos posibles y que podemos probar con PoCs sin disrupción incluyen:

    • Hacia Google Compute Engine (GCE): Ideal para workloads que pueden beneficiarse de familias de máquinas especializadas, incluidas instancias con GPU o TPU.
    • Hacia servicios PaaS de Bases de Datos: Como Cloud SQL, AlloyDB o Cloud Spanner. Muchas de estas transiciones se logran de manera transparente utilizando el servicio nativo Database Migration Service (DMS) para migraciones homogéneas. Esto libera la carga operativa de los DBAs delegando la responsabilidad a Google.
      Un dato de valor, la posibilidad de probar bases de datos como las que mencione y sin disrupción es un gran beneficio, ya que al tener baja latencia entre GCVE and el servicio nativo, las pruebas de concepto no impactan el servicio de producción.
    • Hacia Contenedores (Cloud Run / GKE): GCVE facilita identificar qué VMs son candidatas naturales para avanzar hacia modelos cloud-native cuando llegue el momento.

    Seguridad Nativa y Mitigación de Riesgos

    Y no nos limitemos únicamente en la modernización de nuestras aplicaciones. La preocupación por la seguridad en la nube es natural, y en Google Cloud se aborda con un enfoque de “menor privilegio” y “guardrails” claros.

    • La interconexión de GCVE con el VPC del cliente permite configurar micro-firewalls granulares, garantizando que solo los puertos y servicios estrictamente necesarios estén abiertos.
    • Servicios como Cloud Armor, Next Generation Firewall (NGFW) y Security Command Center (SCC) ofrecen una batería de protección y análisis. SCC, en particular, analiza la infraestructura and alerta sobre riesgos, ofreciendo una guía de best practices para mitigar vulnerabilidades como ataques de ransomware.
    • Y algo fundamental: establecer un Foundation adecuado desde el inicio, definiendo límites, permisos y controles por perfil de usuario, para evitar configuraciones riesgosas o costos inesperados. Desde Wetcom podemos acompañarlos en este diseño.

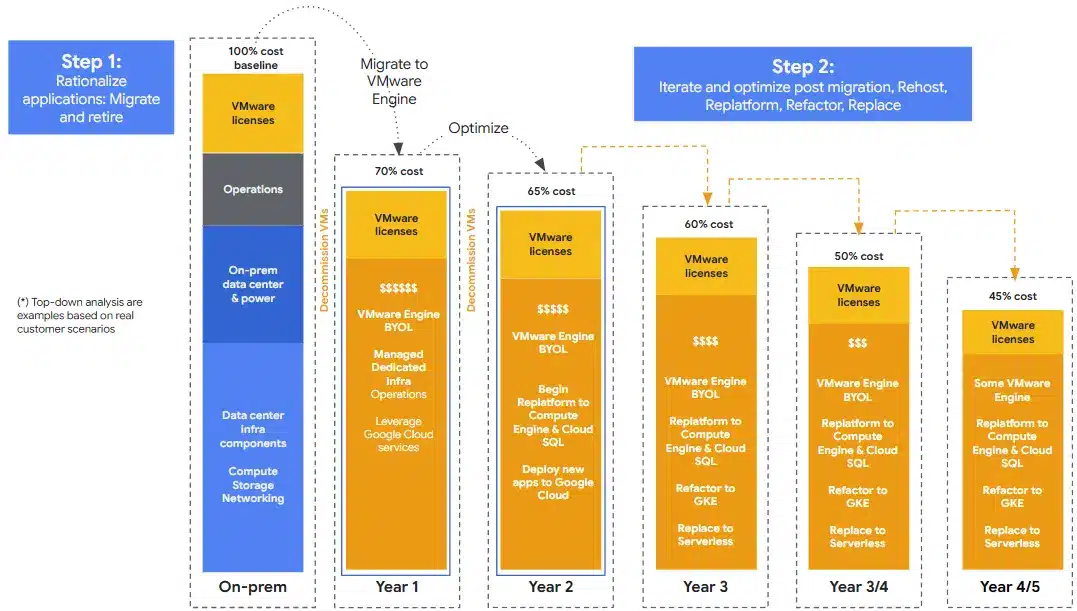
    Pero mejor, veamos esta gráfica que resume claramente el recorrido que estamos describiendo:

    Steps migración on prem a nube

    Esta gráfica de Google Cloud resume la hoja de ruta que podemos diseñar, mostrando cómo se pasa de un costo base del 100% on-premise a aproximadamente un 45% del costo original en el quinto año. Lo interesante es que este ahorro puede sostenerse —y amplificarse— gracias a los Flex CUDs, que permiten transicionar el compromiso a distintos servicios de cómputo a medida que avanzamos con el Replatform & Refactor hacia servicios como GCE o GKE. Esto habilita liberar nodos de GCVE y reducir, de forma progresiva, parte del licenciamiento de VMware que quedaría en desuso.

    El resultado final es un entorno híbrido optimizado:

    • GCVE para aquellas aplicaciones legacy que necesitan seguir ejecutándose allí, a milímetros de los servicios nativos de Google.
    • Y el resto de las aplicaciones ya modernizadas sobre GCE, GKE o bases de datos como servicio, aprovechando todo el potencial de la nube.

    El proceso puede requerir tiempo para determinadas cargas de trabajo, pero el impacto acumulado habilita un aprovechamiento total del TCO de tu infraestructura con el correr de los años.

    Inversión Inteligente, Futuro Asegurado

    La elección de GCVE no es un compromiso con la tecnología de ayer, sino una decisión inteligente de migración. Te permite resolver la urgencia del presente mientras habilitás el futuro de la modernización, con la flexibilidad financiera que ofrecen los Flex CUDs.

    Si te quedaste con ganas de indagar un poco más sobre hacia dónde podrías transicionar tus cargas de trabajo en GCP, te recomiendo este episodio de nuestros #InsanePodcasts, donde contamos distintos escenarios posibles: Google Cloud VMware Engine: Cómo evitar la fatiga tecnológica

    ¿Buscás una estrategia segura para evolucionar tu entorno VMware?

    Desde Wetcom podemos acompañarte con un Cloud Assessment 100% bonificado para evaluar tu entorno VMware (o de otra nube) y diseñar una Hoja de Ruta hacia la modernización progresiva.

    ¿Migrando a GCVE? También te ayudamos con la cotización de licencias y nodos.

    Accedé ahora

  • Wetcom alcanza la categoría más alta de partnership de Broadcom

    Wetcom alcanza la categoría más alta de partnership de Broadcom

    El mundo de IT está en constante evolución. Por eso es fundamental mantener alianzas sólidas e impulsar la innovación. En Wetcom, nos complace anunciar que hemos recibido el máximo nivel de VMware by Broadcom Pinnacle Tier en más de 40 países. Este premio reconoce nuestra larga trayectoria y nuestro compromiso con la excelencia y con el éxito de nuestros clientes en la entrega de soluciones y servicios de VMware.


    Seguimos avanzando

    La adquisición de VMware por parte de Broadcom transformó significativamente el mundo tecnológico durante los dos últimos años. Esto condujo a una reorganización de las alianzas en 2024 y nuevamente en 2025. Ante estos cambios dinámicos, hemos mantenido con éxito nuestra condición de partners de Broadcom a nivel regional y evolucionado hacia el nivel más alto posible: PINNACLE PARTNER.


    Wetcom alcanza la categoría más alta de partnership de Broadcom


    Entendiendo la membresía Pinnacle

    Los partners con nivel Pinnacle deben tener la condición de socio de servicios profesionales del programa Expert Advantage, lo que demuestra una capacidad avanzada en la implementación y puesta en marcha de VMware Cloud Foundation (VCF).


    Como socios Pinnacle de Broadcom, debemos garantizar que cada interacción con los clientes se base en la capacidad y el compromiso. Se espera de nosotros que lideremos con excelencia,  que operemos a gran escala y tengamos un impacto real en el camino hacia una nube privada moderna.


    Diego Quintana, CEO y socio fundador de Wetcom S.A. destacó: “Para Wetcom, es una clara oportunidad para diferenciarnos y tener un papel más relevante e impactante en el negocio de VMware y en el de nuestros clientes. Estamos invirtiendo muchísimo en talento y en capacitación, porque compartimos nuestro compromiso con los objetivos de nuestros clientes, guiándolos en transformación hacia una nube privada moderna y ayudándolos a aprovechar todo el potencial de VMware Cloud Foundation (VCF). ”.


    Broadcom se encuentra en pleno proceso de cambio, simplificando todo su ecosistema de partners y apostando a una nueva versión de VMware Cloud Foundation: VCF 9.0. En Wetcom estamos preparados para seguir adelante, con una mayor responsabilidad y un nivel de rendimiento más alto, listos para brindar una experiencia transformadora al cliente en torno a todas las soluciones de VMware.


    Wetcom como Partner Pinnacle de VMware by Broadcom

    Como socio con status Pinnacle de VMware by Broadcom, esperamos seguir ayudando a nuestros clientes a alcanzar su máximo potencial en el mundo digital con las tecnologías de VMware by Broadcom.


    Ser reconocido con el nivel más alto dentro de la jerarquía de partners subraya nuestra amplia experiencia técnica y éxito demostrado en diversos sectores. Wetcom es uno de los 100 Partners Pinnacle a nivel mundial y el primero de Latinoamérica en su categoría.


    Nuestra nombramiento como Partner Pinnacle de VMware by Broadcom llega en un momento crucial, de cambio y evolución en las operaciones y estrategias tecnológicas de nuestros clientes. Wetcom representa sin dudas, hoy más que nunca, un partner con una sólida capacidad para aprovechar la tecnología de VMware, logrando una infraestructura de nube privada moderna, eficiente, segura y altamente disponible.


    Para obtener más información sobre cómo Wetcom ofrece sus servicios a sus clientes en los sectores de servicios financieros, retail, energía y otras industrias, visite www.wetcom.com y sus redes sociales.


    Contacto de prensa: Gabriela González, formulario de contacto

  • Cambios clave en VCF y Tanzu

    Cambios clave en VCF y Tanzu

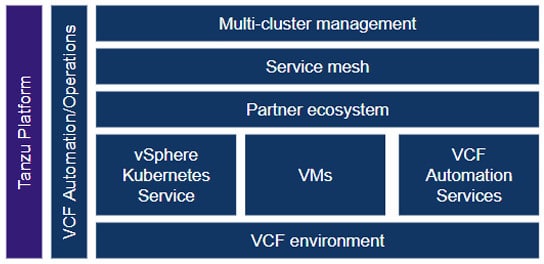
    Recientemente, Broadcom introdujo un cambio importante en su portfolio con el objetivo de fortalecer las capacidades esenciales de VMware Cloud Foundation y convertirla en una plataforma única, donde se puedan correr tantos máquinas virtuales (VMs) como contenedores. Como parte de esta estrategia, Broadcom planea introducir funcionalidades adicionales relativas a Kubernetes dentro de VMware Cloud Foundation (VCF). Esto incluye la gestión de clústeres múltiples y capacidades de «Service Mesh» con el objetivo de ofrecer un set completo de funcionalidades out-of-the-box para la operación y gestión de cargas de Kubernetes, al mismo tiempo que reduce los costos operativos. Mientras tanto, el portfolio de Tanzu se enfocará en sus ofertas de Plataforma como Servicio (PaaS) para aplicaciones y soluciones de gestión de datos.


    Cambios clave en VCF y Tanzu


    A partir de mayo de 2025 Broadcom elimina las siguientes capacidades de VMware Tanzu Platform y las incluye como parte de la oferta de VCF:


    • VMware Tanzu Mission Control:  VCF, VCF Edge y Telco Cloud Platform incluirán Tanzu Mission Control Self-Managed para posibilitar la gestión de clústeres múltiples a escala.


    • Service Mesh Istio:  VCF, VCF Edge y Telco Cloud Platform incluiran Service Mesh Istio para proveer seguridad y observabilidad avanzadas y gestión de tráfico.


    Adicionalmente,  VMware Data Services Manager pasará al catálogo de servicios avanzados -VCF Advanced Services- y ofrecerá una solución Database-as-a-Service (DBaaS) creada especialmente para VCF.


    Cambios clave en el portfolio de Tanzu

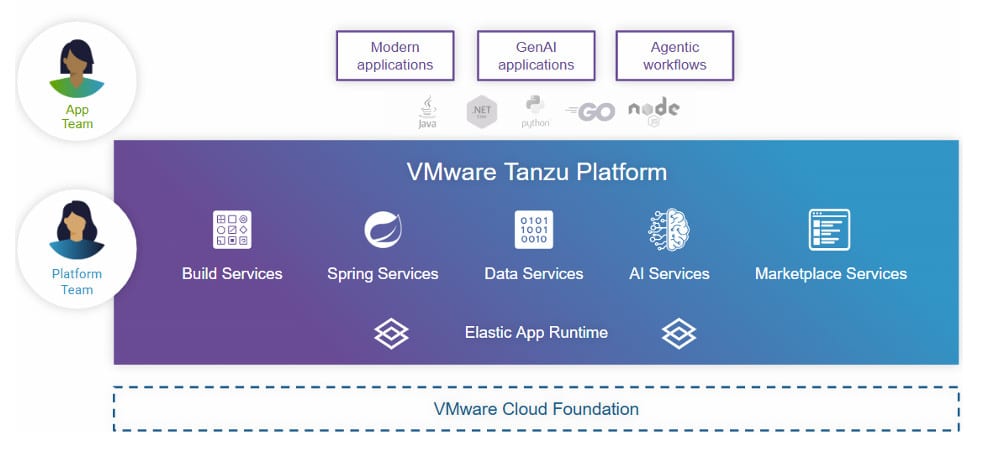
    Con un mayor enfoque en los equipos de aplicaciones, la visión y la misión de Tanzu siguen siendo las mismas: empoderar a las empresas para desarrollar, operar y optimizar aplicaciones modernas basadas en IA y flujos de trabajo de agentes de forma eficiente y a escala, ayudando a acelerar los resultados empresariales.


    Cambios clave en VCF y Tanzu (imagen 2)


    En la segunda mitad de 2025, el portfolio de Tanzu se centrará en las siguientes ofertas:


    • VMware Tanzu Platform:  este SKU ofrece una plataforma como servicio (PaaS) prediseñada, construida sobre el entorno de ejecución de aplicaciones elásticas basado en Cloud Foundry que se instala directamente sobre VCF.  La plataforma Tanzu acelera el proceso completo de desarrollo, tanto para aplicaciones modernas como para aplicaciones GenAI.
    • VMware Tanzu Spring Essentials: este SKU ofrece Build Service y Spring Services para su uso fuera de la plataforma de Tanzu, directamente con VCF.
    • VMware Tanzu Application Catalog: este SKU continuará ofreciendo software open spurce, seguro, robustecido  y empaquetado para su uso fuera de la plataforma de Tanzu, directamente con VCF.
    • VMware Tanzu Data Suite: este SKU ahora contiene VMware Tanzu GemFire -un sistema de gestión de datos en memoria distribuida- y la plataforma de almacenamiento de datos, análisis e inteligencia artificial VMware Tanzu Greenplum
    • VMware Tanzu Data Services: este SKU continúa disponible como parte del SKU de código abierto Tanzu Data Services, que es compatible con Postgres, MySQL, Valley y Tanzu Data Lake en máquinas virtuales, Kubernetes y entornos Bare Metal.
    • VMware Tanzu RabbitMQ: ahora está disponible como un  SKU independiente.
    • VMware Tanzu Kubernetes Grid multi-cloud (TKGm) legacy runtime: Broadcom seguirá incluyendo TKGm en Telco Cloud Platform para clientes de Telco.  La oferta independiente de  TKGm dejará de estar disponible. La recomendación para aquellos clientes que tengan TKGm es moverse a  vSphere Kubernetes Service.
    • Tanzu Mission Control SaaS (TMC SaaS): TMC SaaS será eliminado de Tanzu Platform y ya no estará disponible para su adquisión. Recomendamos a los clientes que tengan TMC SaaS transicionar a TMC Self-Managed incluido en VCF.