Categoría: Disponibilidad

  • NUEVO Veeam Backup & Replication v11

    NUEVO Veeam Backup & Replication v11

    Veeam® Software, el líder en soluciones de respaldo, hoy anunció el lanzamiento del NUEVO Veeam Backup & Replication™ v11.  La nueva solución 4-en-1 combina respaldo, replicación, snapshots de almacenamiento y como novedad, Protección de Datos Continua (Continuous Data Protection, CDP por sus siglas en inglés).


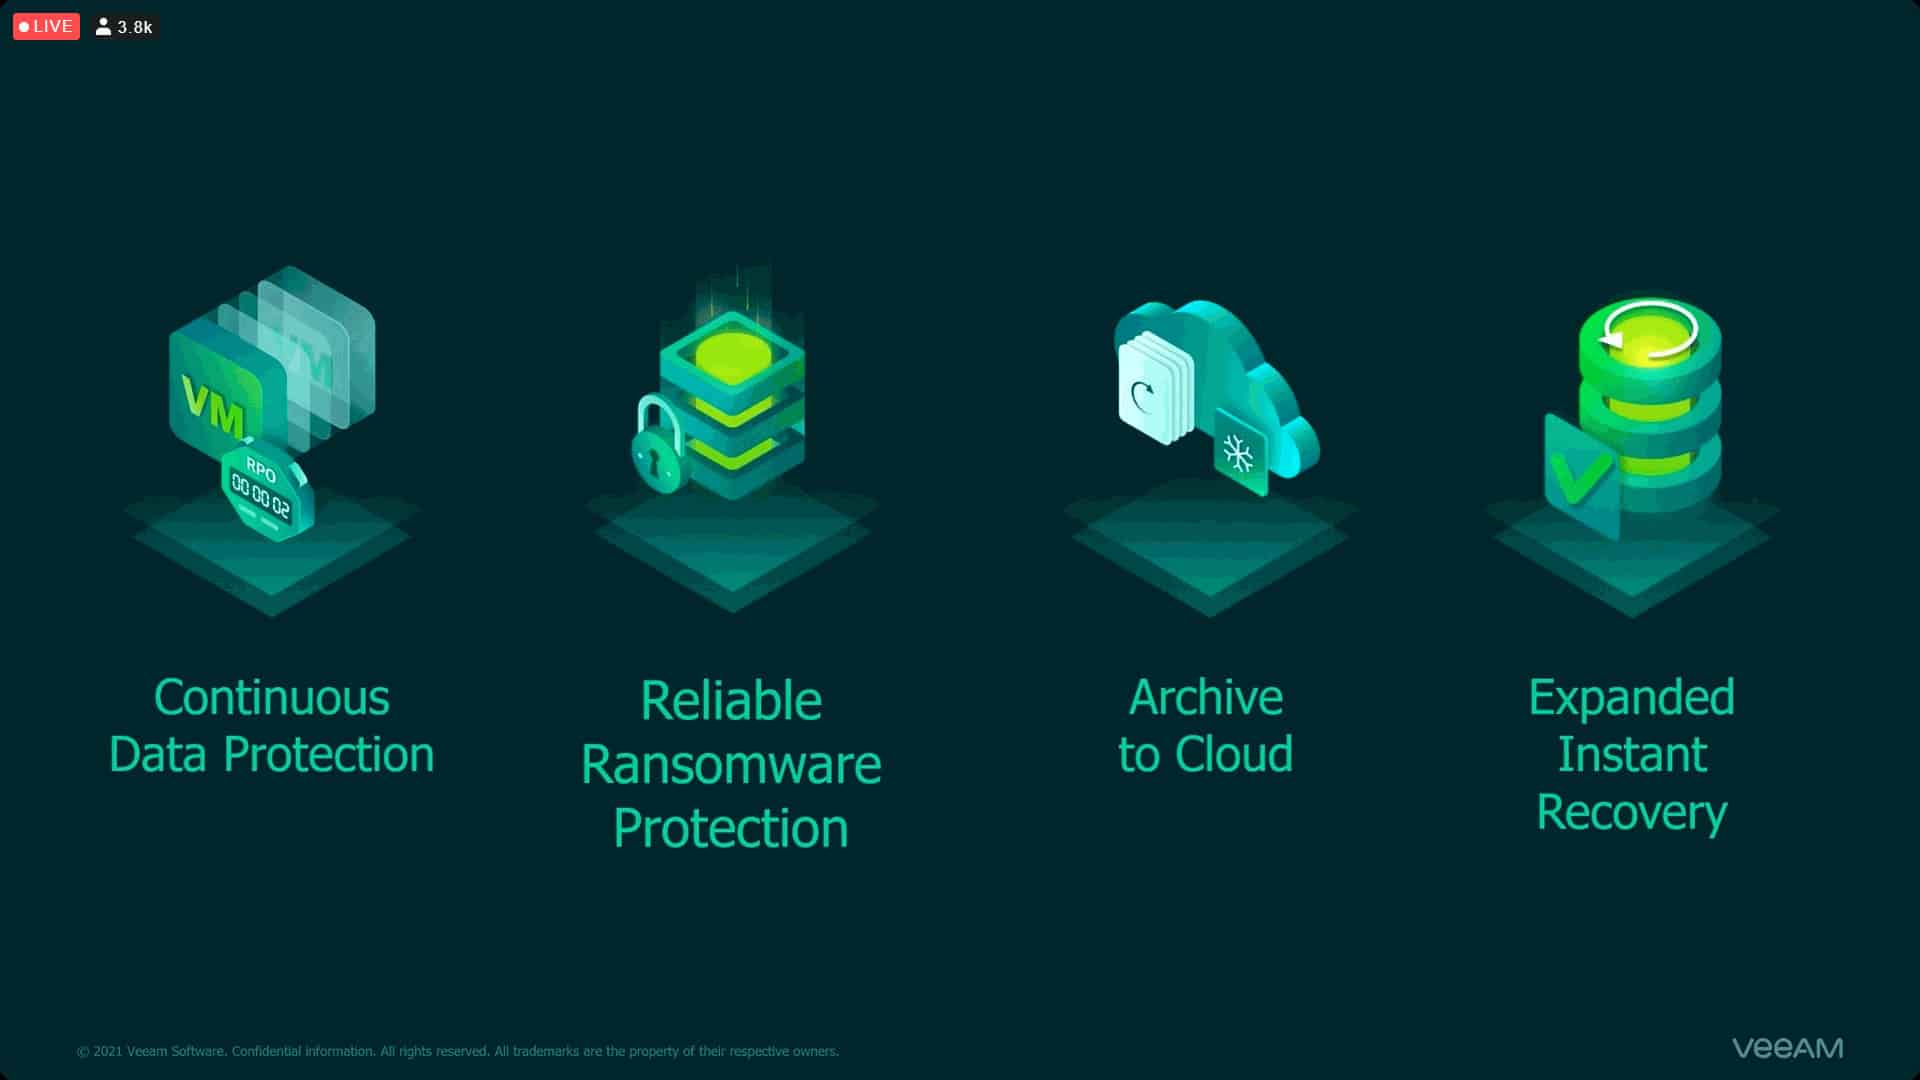
    El nuevo Veeam v11 permite a las empresas aprovechar 4 funciones principales como parte de una solución de protección de datos completa:
    Protección de Datos Continua (CDP), protección confiable contra el Ransomware, archivo y retención en la Nube y recuperación instantánea extendida.
     

    NUEVO Veeam Backup & Replication v11


    1. Recuperación ante Desastres con Protección de Datos Continua (CDP)


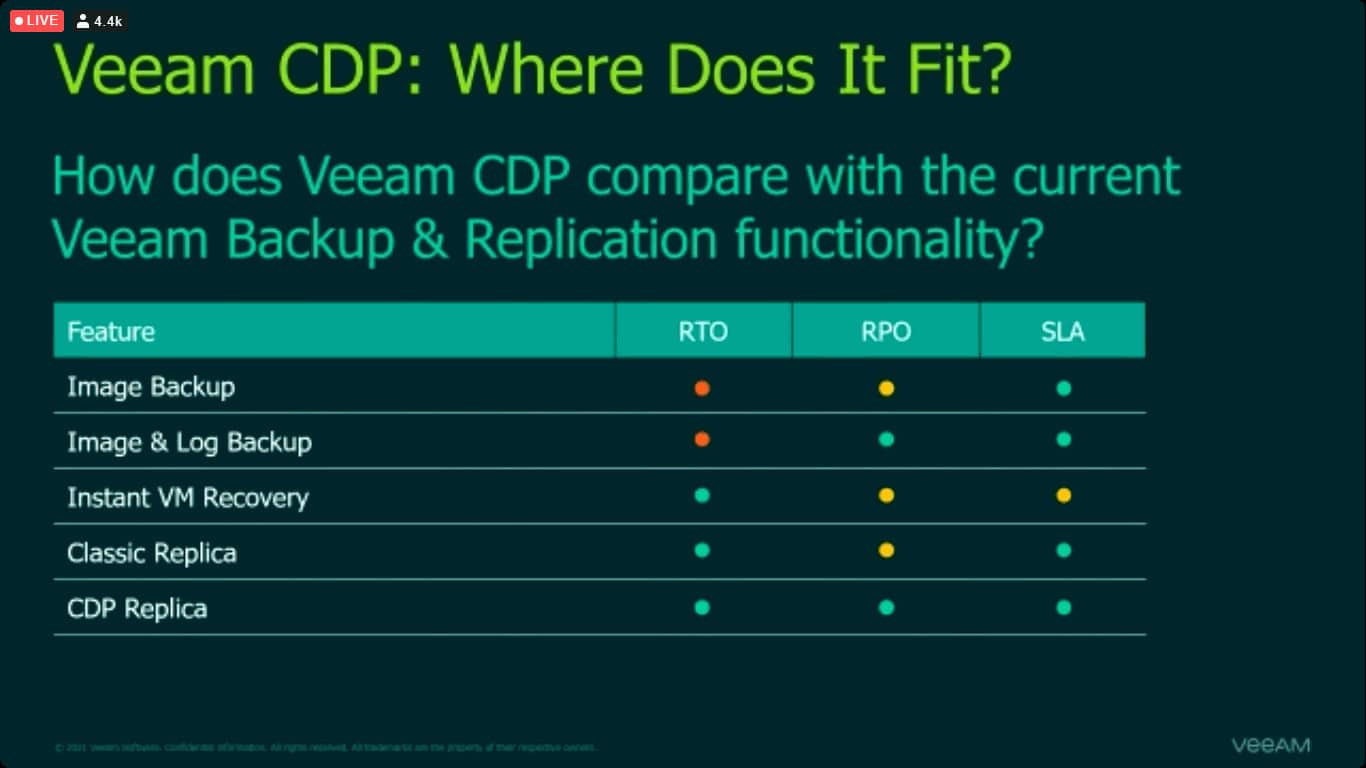
    Esta función elimina el tiempo de inactividad y minimiza la pérdida de datos para las cargas de trabajo de VMware de Nivel 1 con CDP integrado. Es posible lograr recuperaciones inmediatas al último estado o al punto del tiempo deseado, minimizando la pérdida de datos y un mejor RPO (volumen de datos en riesgo de pérdida).


    El CDP de Veeam representa una versión más avanzada para réplica de máquinas virtuales , en tan solo “en cuestión de segundos”. De esa manera,  aumenta la disponibilidad de las VMs críticas, que requieren de un RPO lo más chico posible.


    NUEVO Veeam Backup & Replication v11 (imagen 2)


    2. Protección confiable contra Ransomware

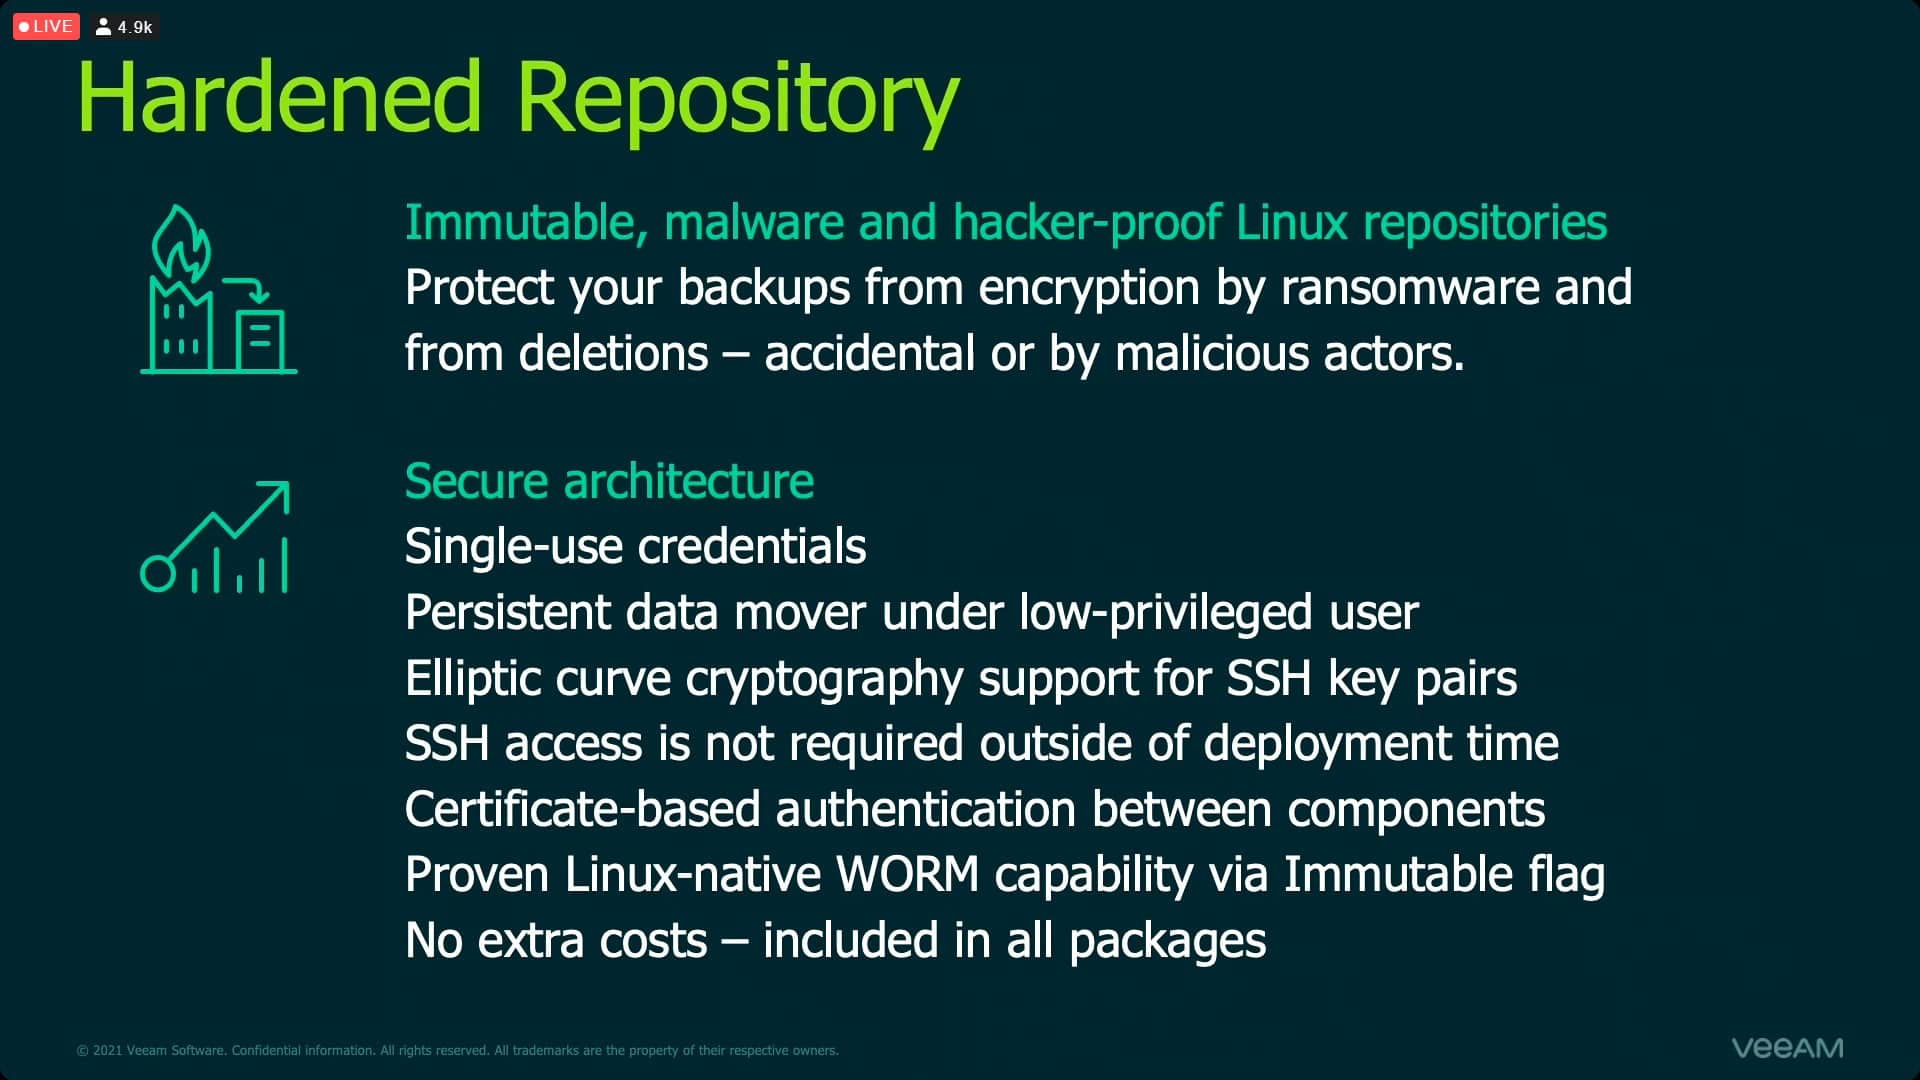
    En respuesta a los nuevos desafíos de protección de datos y riesgos de ciberataques que muchas empresas enfrentaron en 2020 durante la pandemia,  la nueva V11 incluye protección contra ransomware y seguridad confiable.


    Los respaldos seguros con repositorios de Linux inmutables y reforzados previenen el cifrado por ransomware, eliminaciones accidentales o maliciosas.


    NUEVO Veeam Backup & Replication v11 (imagen 3)


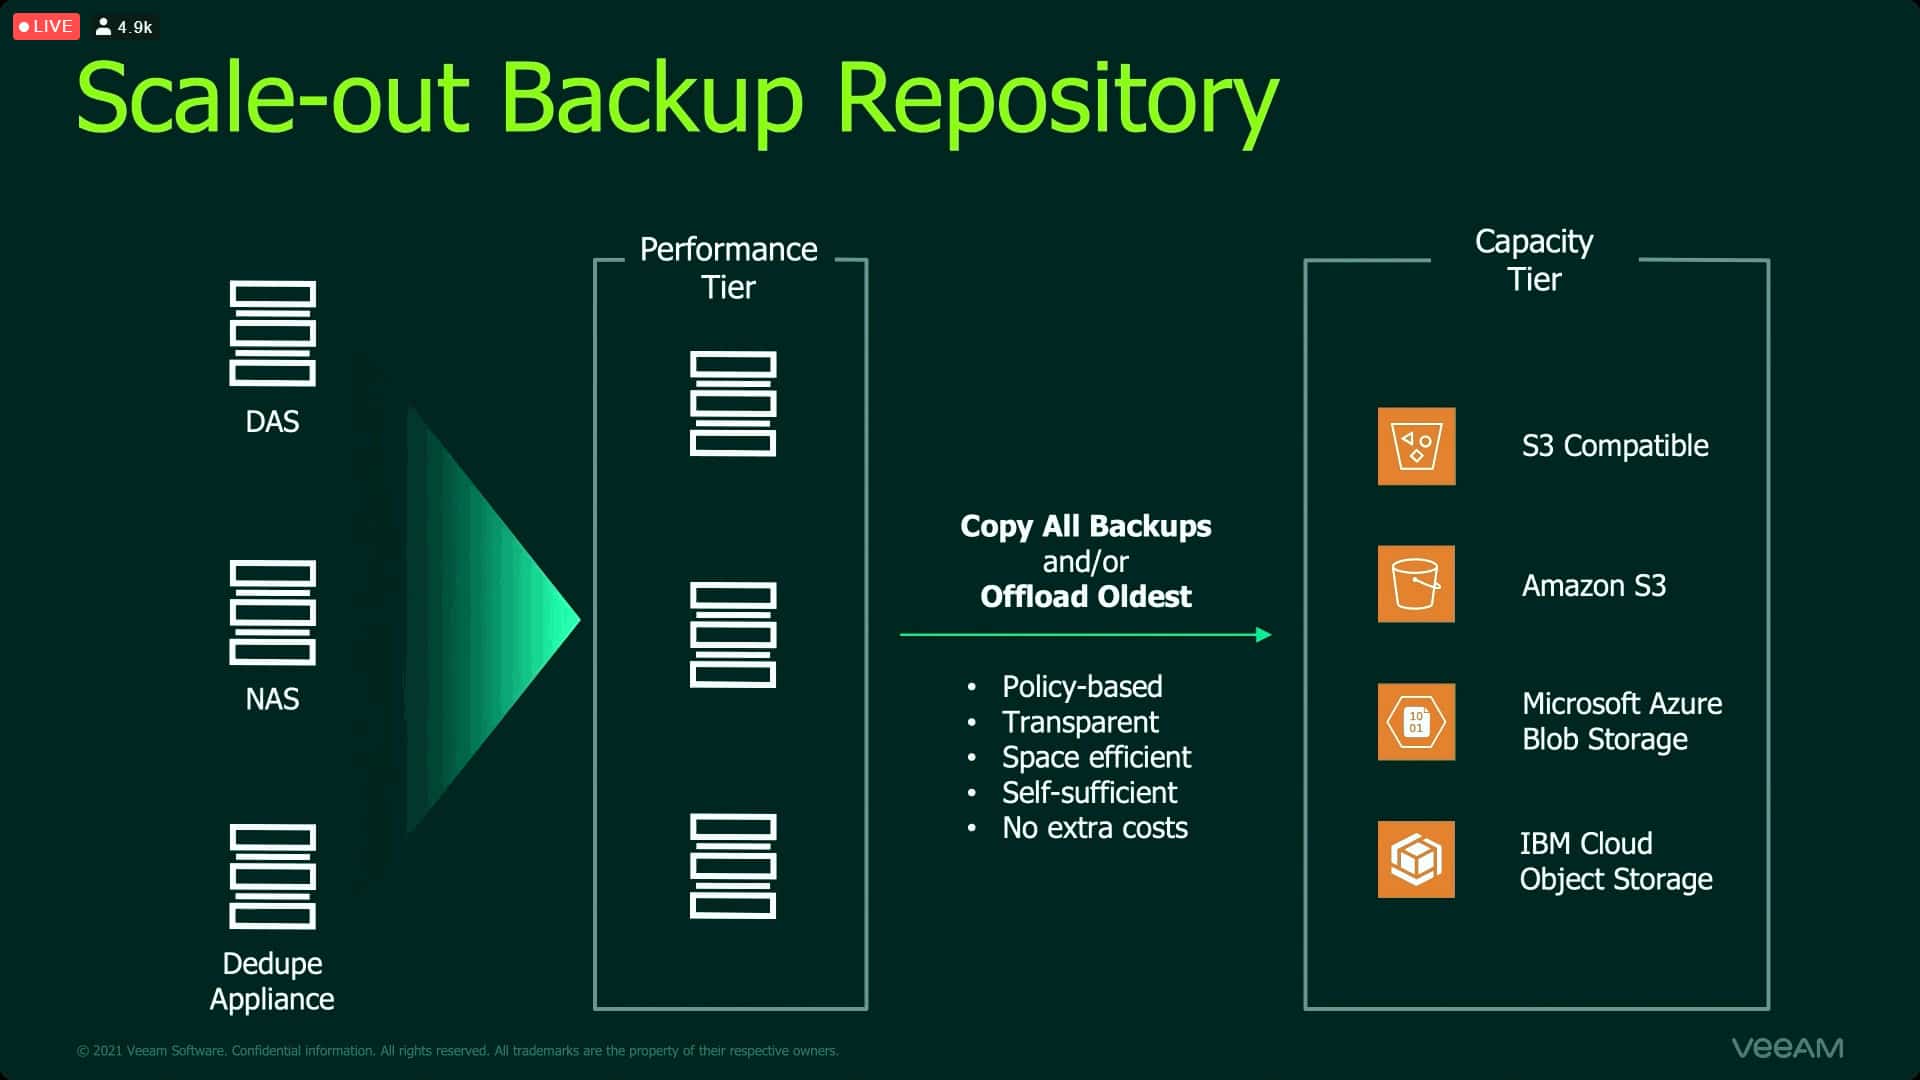
    3. Archivo y retención de datos en la nube

    La gran novedad en este sentido es la integración nativa para hacer respaldo de máquinas virtuales que están en Google Cloud. Asimismo,  la v11 de Veeam Backup & Replication posibilita llevar los backups de un on-premises a un repositorio en Google llamado Google Cloud Storage.


    Asimismo, con la nueva versión de Veeam Backup & Replication, se busca proteger el ciclo de vida de los datos en un entorno multi-nube para AWS y Microsoft Azure.


    Con AWS S3 Glacier y Azure Blob Archive es posible reducir hasta 20 veces los costos de archivo y retención de datos a largo plazo y reemplazar la administración manual de cintas con el nuevo soporte nativo para Amazon S3 Glacier (incluyendo Glacier Deep Archive), Microsoft Azure Archive Storage a través de Veeam Scale-out Backup Repository™ Archive Tier.


    NUEVO Veeam Backup & Replication v11 (imagen 4)


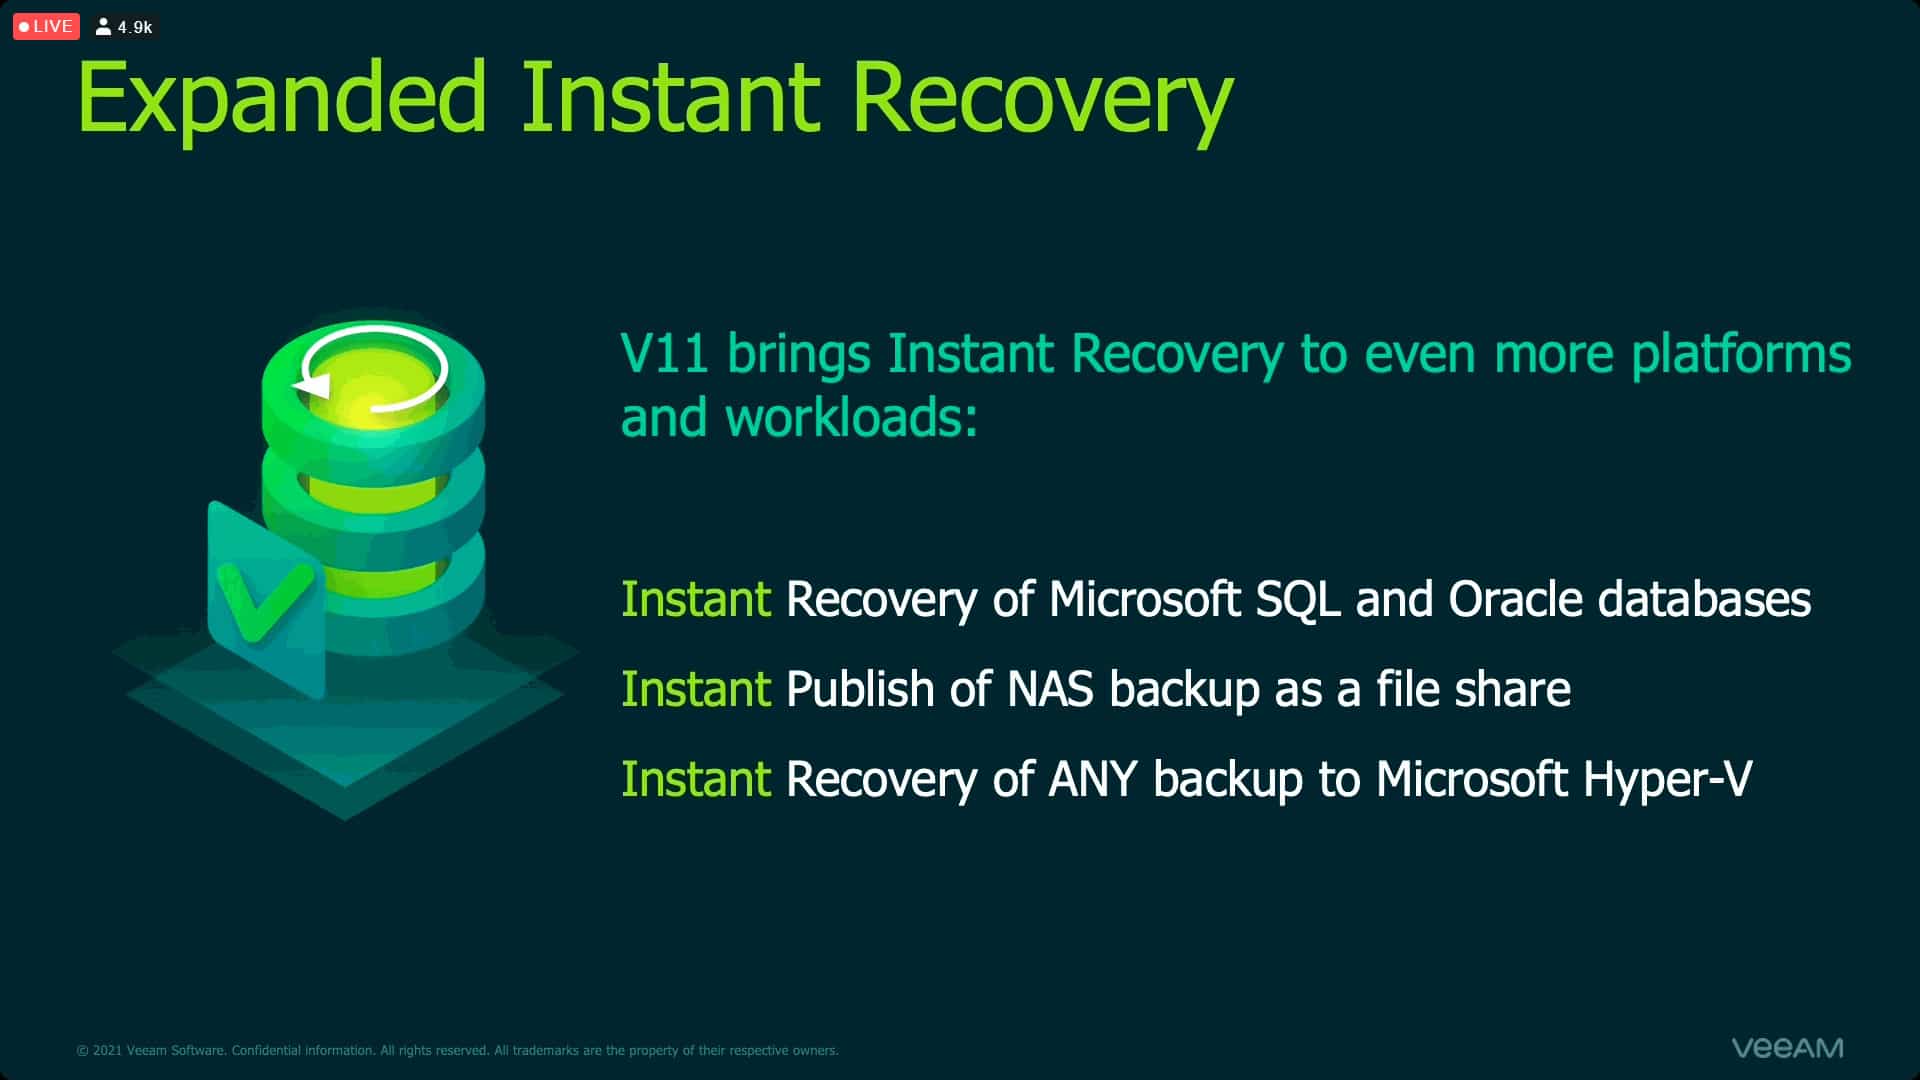
    4. Recuperación instantánea extendida

    La versión anterior de Veeam Backup & Replication ya contaba con la capacidad de restaurar rápidamente ante cualquier escenario de recuperación para lograr la continuidad del negocio. Esta nueva versión, V11,  facilita la recuperación instantánea con objetivos de tiempo de recuperación (RTO) más bajos en nuevas plataformas y cargas de trabajo: Microsoft SQL, bases de datos Oracle y recursos compartidos de archivos NAS.


    NUEVO Veeam Backup & Replication v11 (imagen 5)


    En resumen, Veeam Backup & Replication v11 es una solución de backup integral con más de 200 mejoras adicionales de respaldo, nube, DR, seguridad y automatización, coherente con las necesidades y demandas de confiabilidad de datos que requieren las empresas hoy en día.
  • Cómo funciona Auto Remediation en VMware Cloud on AWS

    Cómo funciona Auto Remediation en VMware Cloud on AWS

    ¿Cómo funciona auto remediation en VMware on AWS?

    En este post quiero contarte cómo funciona el auto remediation, la función de remediación de clusters de VMware on AWS, para tolerar y accionar ante la falla de uno o más hosts de un cluster.


    Junto con el balanceo de carga en VMC, una de las más grandes dudas con las que nos encontramos por parte de nuestros clientes es: ¿qué pasa si un host del cluster de VMware en AWS sale de servicio?


    Para responder a esta pregunta tenemos que conocer un poco más sobre cómo funciona la función de Auto Remediation en VMware on AWS,  o simplemente, VMC.


    ¿Qué es Auto remediation en VMware on AWS?

    ¿Qué pasa si un host del cluster en AWS se muere? Para responder a esto tenemos que hablar de Auto Remediation.


    A diferencia de cuando tenemos los hosts en nuestro centro de cómputos y somos responsables por accionar ante la falla del hardware de uno de éstos, cuando hablamos de VMware Cloud on AWS el responsable de accionar ante la falla de hardware y resolver la situación es VMware.


    Si bien es invisible para el usuario final, es importante discutir cómo funciona para que puedas entender qué es lo que está pasando cuando se dispara y qué se verá  en la consola cuando sucede.


    ¿Cómo funciona Auto remediation en VMware on AWS?

    Uno podría pensar que el funcionamiento es similar al de VMware High Availability (HA) que está hace años a disposición de los usuarios. La realidad es que el enfoque es un poco diferente debido a las características de la solución.


    VMware monitorea el correcto funcionamiento de los clusters de VMware Cloud on AWS y ante la falla de algún componente puede poner a disposición del cliente un hardware nuevo, de forma automática, y muy pero muy rápido.


    Debido a estas dos cosas, ante una falla se aprovisiona un nuevo servidor en cuestión de minutos, y como a nivel de almacenamiento se utiliza VSAN, las máquinas virtuales se sincronizarán al nuevo servidor y por medio de HA, serán encendidas.


    El proceso de Auto Remediation en VMware on AWS es completamente automático y dependiendo del tipo de servicio que ejecuten las máquinas virtuales afectadas, probablemente el usuario final no llegue a enterarse.


    Si bien DRS y HA corren en los clusters, la funcionalidad de Elastic DRS en VMC hace que reemplazar un nodo que sale de servicio por problemas sea algo muy rápido.


    Para conocer un poco más sobre cómo funciona Auto remediation en VMware on AWS les dejo este video donde pueden ver una simulación de caída de un host del cluster y cómo Auto Remediation resuelve la situación agregando un nuevo host.


    Si querés conocer más sobre Auto remediation en VMware on AWS o de las soluciones de VMware Cloud, escribinos y te responderemos a la brevedad.

  • Wetcom named Impact Partner of the Year SOLA by Veeam

    Wetcom named Impact Partner of the Year SOLA by Veeam

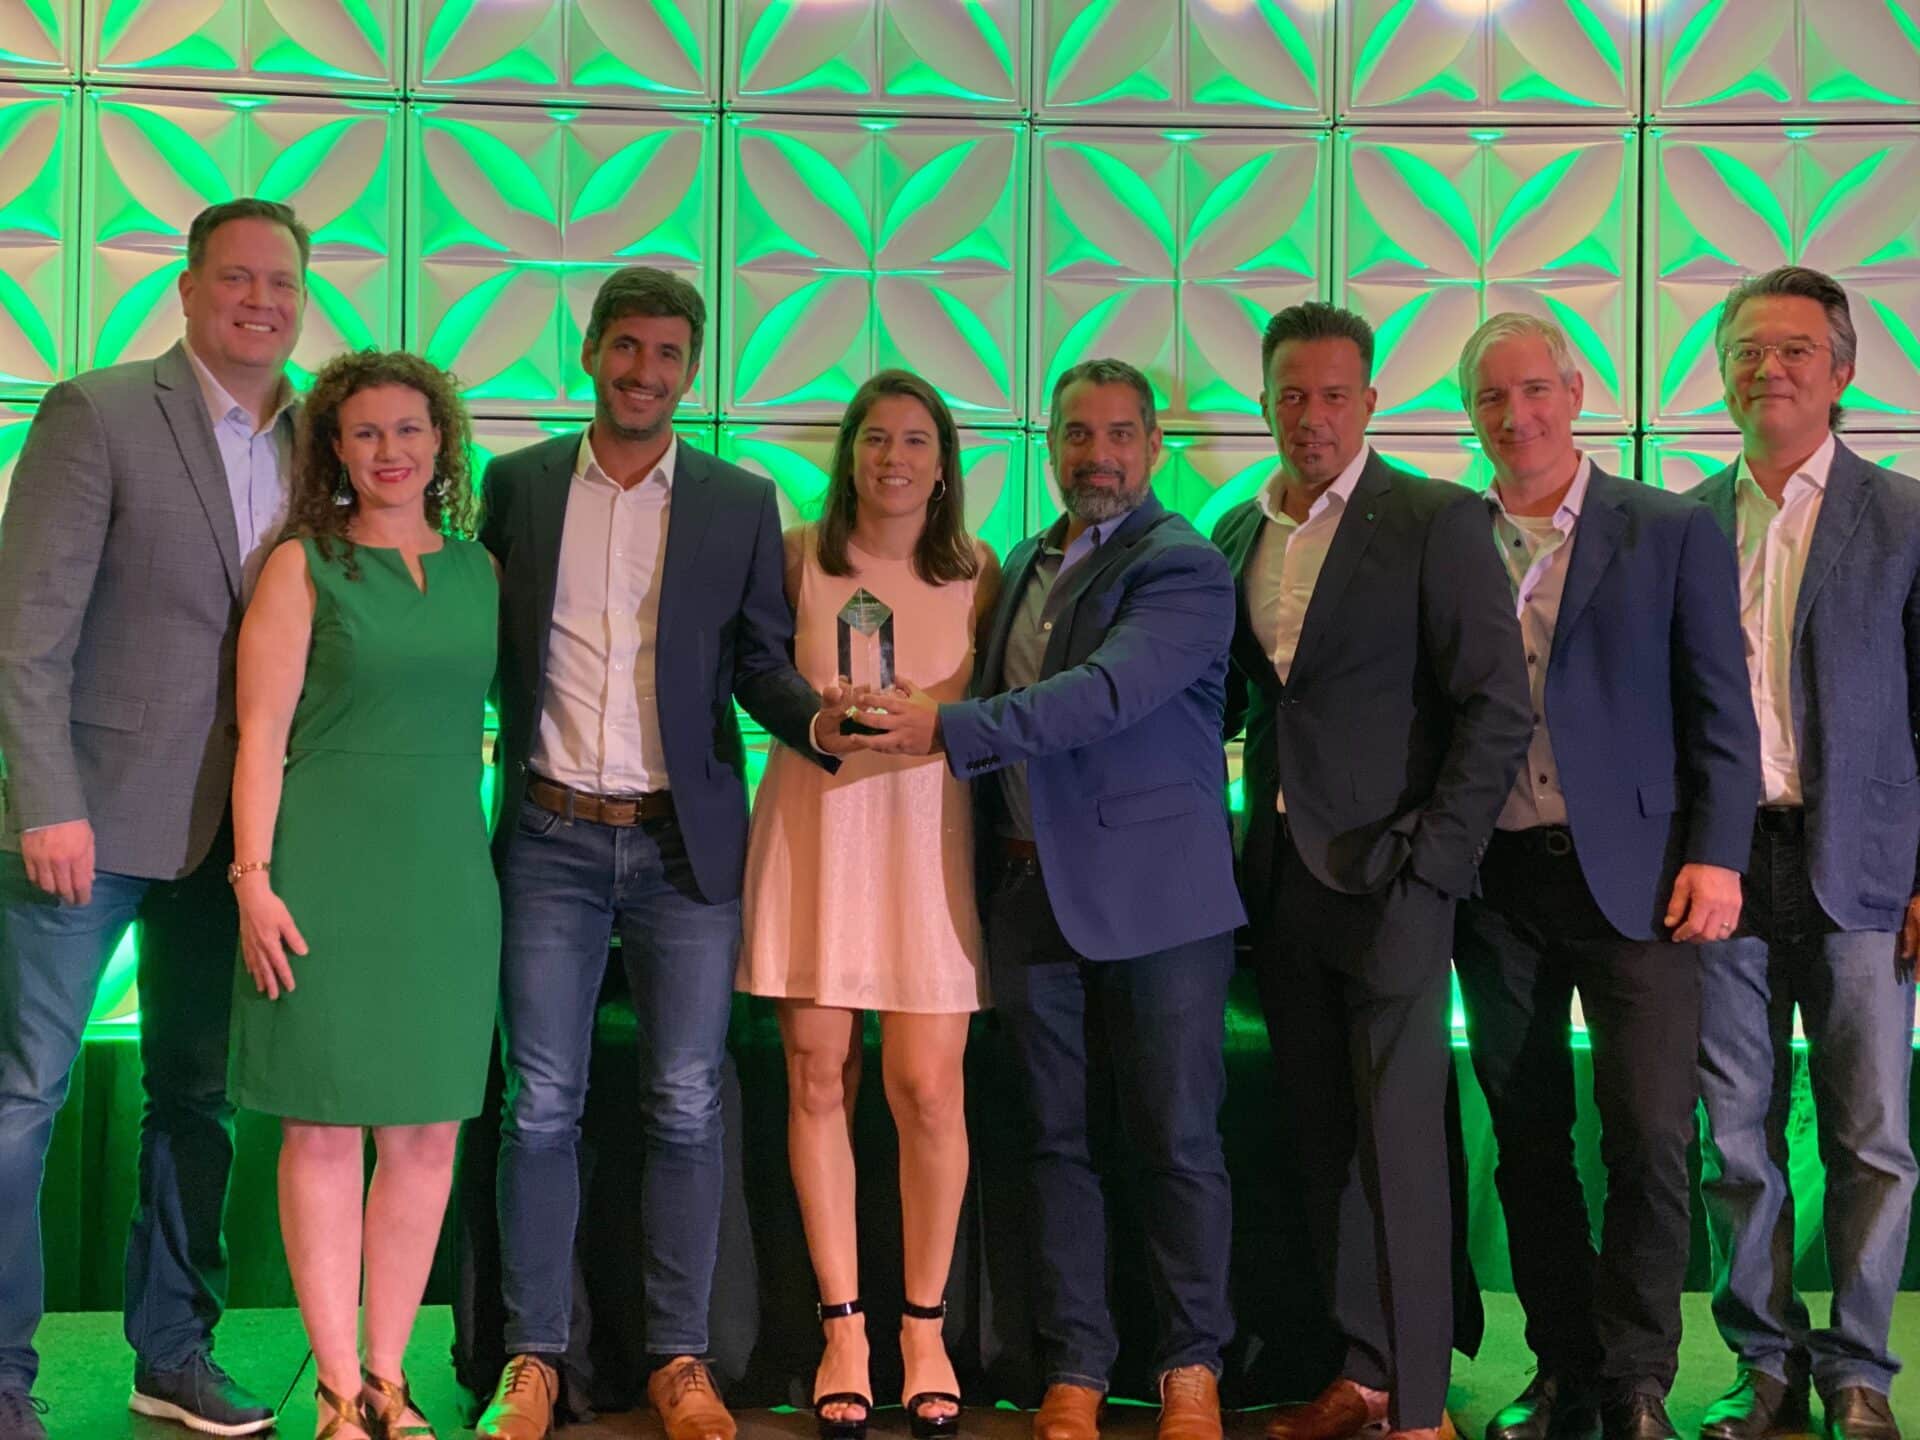
    Buenos Aires, Argentina – March 10th, 2020: Wetcom S.A., a virtualization and cloud computing services company, proudly announces it has been selected as the 2019 (Award Name) by Veeam® Software, the leader in Backup solutions that deliver Cloud Data Management™. These annual awards recognize Latin America Veeam ProPartners and Veeam Cloud & Service Provider (VCSP) partners who have not only demonstrated success in providing Veeam solutions to their customers, but who have also provided first-class support, expert knowledge, continued product education, and a true Veeam strategy incorporated into their business. 


    Wetcom was recognized as Veeam Impact Partner of the Year, SOLA for demonstrating the best overall performance in areas of consistent revenue growth, collaboration with Veeam and proactive selling, and promoting Veeam solutions and adjacent technologies.


    “We are excited to recognize and honor Wetcom as the Impact Partner of the Year,” said Kevin Rooney, vice president of Americas channels at Veeam. “As a 100-percent channel company, we attribute much of our profitable growth and success to our partners. Wetcom’s commitment to Veeam, product expertise, and ability to deliver the best Cloud Data Management solutions in the industry make them an ideal Veeam partner. We applaud Wetcom for their loyalty and service to our joint customers, and look forward to an even stronger partnership in 2020.”


    «We are really proud of having achieved the Impact Partner of the Year recognition by Veeam. This award reinforces our commitment with the leader company in Backup solutions,  and places the rod high as to further deepen our knowledge of the latest Veeam solutions to deliver our customers a valuable alternative to availability problems,» said Diego Quintana, Managing Director at Wetcom S.A.


    About Wetcom S.A.:

    We are a company made of a professional team passionate about putting the use of virtualization and cloud computing technologies into practice.

    Our professional services are designed to help your IT talented resources focus on business projects… as we deal with the rest for you!Somos una empresa de profesionales apasionados por llevar a la práctica el uso de tecnologías de Virtualización y Cloud Computing..
    For further information on how to modernize your data protection, contact us.

  • Veeam 10: backup para el futuro

    Veeam 10: backup para el futuro

    Dicen que lo bueno se hace esperar y este caso no será la excepción. Finalmente llegó la versión 10 de Veeam Availability Suite, el especialista en gestión de datos y recuperación de información, ya sea en la nube, virtuales o físicas. Desde su sede matriz comunicaron que para toda la suite de productos se implementaron unas 150 mejoras aproximadamente.


    Aunque nos gustaría enumerar todas y cada una de ellas, sabemos que tu tiempo vale, así que hicimos una minuciosa selección de las 7 «features» más destacadas de este esperado lanzamiento.


    1. Backup de NAS más avanzado

    Citamos esta funcionalidad en primer término, porque era un gran punto de mejora pendiente y que cientos de clientes requerían.

    Ahora, en la versión 10, se mejoraron las capacidades intuitivas del Backup de NAS de Veeam, agregando funciones de monitorización y generación de informes integradas, con soporte CRC para poder obtener Backups tan ágiles como confiables, de sus servidores compartidos y de archivos de NFS (3.1 y 4.0), SMB (todas las versiones) y CIFS.

    Ya no es necesario realizar “active full backups” de manera periódica ya que la nueva versión permite realizar «forever incremental backups» a través del protocolo NDMP.


    2. Recuperación instantánea de múltiples VMs

    Si, tal cual acabas de leer, una de las características más potentes de Veeam ha perfeccionado su alcance. En esta versión será posible restaurar cualquier Backup realizado con Veeam usando“Instant VM Rcovery” a una, o, múltiples VMs de VMware. Esto hará que puedas ser más eficiente en la recuperación ante desastres, obteniendo restauraciones masivas, impulsadas por el motor de recuperación instantánea “Next Generation” de Veeam.


    3. Modo de copia Veeam Cloud Tier

    Desde Veeam Cloud Tier podrás activar una nueva funcionalidad de “copy mode” que te permitirá copiar los bloques modificados al instante cuando se realice el Backup, permitiendo maximizar y aprovechar las ventanas de asignación de ancho de banda, además de poder minimizar considerablemente la pérdida de datos.


    4. 100% a prueba de Ransomware

    Conforme avanza y mejora la tecnología, también lo hacen los sistemas que la vulneran, es por eso que Veeam desarrolló un espacio para la nube que permite configurar un modo de inmutabilidad inteligente para Cloud Tier, es decir, podrás mover tus datos remotamente y protegerlos al mismo tiempo.


    5. Monitorización y generación de informes para Nutanix AHV

    La consola de Veeam ONE ahora incluye monitorización, informes y alertas sobre la protección de datos de Nutanix AHV para ayudarte a tomar decisiones, en torno a la protección de cargas de trabajo de Nutanix y poder elaborar informes de gestión corporativa.


    6. Diagnóstico Inteligente de Veeam:

    Veeam 10 admitirá ampliar las capacidades de análisis de registros de datos para componentes remotos, así como, dar soporte a sistemas localizados en servidores de Veeam Backup & Replication.


    7. Backup Inteligente

    Basta de copiar manualmente el registro de transacciones SQL fuera del sitio. Ahora podés dejar que Veeam se encargue automáticamente de dichas tareas, logrando un análisis de datos de forma mucho más eficiente:


    Cómo habrás visto, con estas últimas actualizaciones de Veeam, podés estar mejor preparado para las necesidades futuras de tu negocio porque la protección de datos es más simple, confiable y eficaz que nunca. Si querés saber más acerca de todas las novedades que Veeam Versión 10 puede ofrecerte como solución de disponibilidad, contactanos.

  • Todo lo que tenés que saber de las nuevas Licencias Universales de Veeam (VUL)

    Todo lo que tenés que saber de las nuevas Licencias Universales de Veeam (VUL)

    Si te resultaba confuso el modelo por instancias, tenemos una buena noticia: Veeam lanzó una nueva forma de licenciar sus soluciones de disponibilidad, simplificando su dimensionamiento. 


    En Wetcom, sabemos que en cada proyecto, el problema va primero, y la tecnología después. Si estás decidido a implementar Veeam como tu solución de Backup, podemos acompañarte en tu camino de la Alta Disponibilidad con el expertise de un Veeam Impact Partner of the Year.


    En este caso, abordaremos los insights más relevantes de las Licencias Universales de Veeam (por sus siglas en inglés, VUL) lanzadas oficialmente el pasado 01 de octubre y que vienen a reemplazar el esquema por suscripción o “instancia” (VIL).  A continuación, todo lo que tenés que saber:


    ¿Por qué Universal?

    Las licencias se denominan universales porque este formato consta de un software de licencia por cada carga de trabajo protegida, ya sea a nivel VM (virtual machine) “On-Premises”, VM en la nube, Servidor Físico o hasta un recurso compartido de archivos, con características portables, es decir, que pueden ser “movidas” a distintos ambientes.


    La flexibilidad de este tipo de licencias hace que sean independientes de la carga de trabajo a la que estén asignadas. Esto significa que podrás reutilizar una misma VUL en otros entornos, simplificando el modelo de consumo y acotando los costos de CapEx de tu organización.


    ¿Qué productos se licencian con VUL?


    • Veeam Availiability Suite ®

    • Veeam Back up & Replication®
    • Veeam Back up Essentials ®
    • Veeam Backup & Replication para AWS ®

    •  Veeam ® Agents para Microsoft Windows y Linux


    ¿Cómo se vende?

    Vienen agrupadas en “paquetes” de 10 unidades (1 bundle = 10 VUL).


    Si tenés un entorno de 10 o menos cargas de trabajo podrás protegerlas de forma gratuita, accediendo a la Community Edition de Veeam.


    Al igual que ocurría con las instancias, podrás ajustar un calendario de pagos con opciones de suscripción de uno a cinco años, pudiendo abonar anualmente, o por adelantado.


    ¿Qué Precio?

    Los valores que se reflejan a continuación son estrictamente referenciales para USA. Tomar en cuenta que de acuerdo al país y sus políticas impositivas estos precios varían USD $1.500 1/ año de 10 VUL Veeam Availability Suite USD $1.200 1/año de 10 VULs Veeam Back-up & Replication USD $800 1/año de 10 VUL Veeam Back-up Essentials.


    ¿Y el soporte?

    En todos los productos licenciados con VUL, el soporte que viene incluido es de tipo Production: 7x24x365.


    ¿Qué pasa si ya tengo adquirida licencias por instancias?

    A partir del próximo update de producto o renovación de contrato que hagas, se actualizará automáticamente tu cuenta hacia el esquema de licencias VUL.


    ¿Querés saber más?

    Si ya estás decidido a aprovechar todos los beneficios de las Licencias Universales de Veeam, te decimos cómo.

  • 5 cosas que podemos aprender del apagón

    5 cosas que podemos aprender del apagón

    Hace unas semanas vivimos un apagón que afectó a casi todos nuestros clientes en mayor o menor medida. Me gustaría en este post recorrer algunos de los puntos más notables de esas horas de incertidumbre.


    De estos puntos hay buenos, malos y feos. Todos relacionados con los servicios de TI propios y de nuestros clientes, de la operatoria y de planes que deberían haber funcionado de otra forma.


    Y hablo de propios porque dentro del incidente nosotros también vimos afectada parte de nuestra operación.  Estas cosas que tenemos que aprender fueron identificadas durante la crisis y analizadas posteriormente. 


    Desde los primeros minutos nos pusimos en contacto con nuestros clientes, sin importar qué tipo de servicio hubiera contratado con nosotros. Queríamos identificar los siguientes puntos: 


    1- Si tenían servicios afectados.

    2- Estado de la operación del negocio.

    3- Cuál era el plan de acción, si tenían.

    4- La criticidad para devolver el servicio durante un domingo.


    Debido a que tenemos clientes en las más diversas verticales, algunos tenían que operar el domingo sí o sí, y otros podían esperar a la madrugada del lunes.   


    De estas comunicaciones con los clientes y de las respuestas que obtuvimos, creamos este listado.


    Vamos a empezar por lo bueno, lo que creo que funcionó bien dentro de todo ese proceso de incertidumbre.


    No estamos tan mal como parece

    Este es uno de los puntos buenos que quiero destacar. A pesar de lo que uno puede pensar, fueron pocos los clientes nuestros que vieron afectados completamente sus servicios.


    Al menos desde el punto de vista de los servicios primarios del centro de cómputos.


    Léase energía eléctrica junto con todos sus derivados (UPS, generadores, etc.) y refrigeración.


    En casi todos los casos, por uno u otro método, los servicios continuaron siendo entregados con una mínima interrupción.


    Los planes e inversiones que se hicieron en los últimos años demostraron ser eficientes.


    Las comunicaciones siguen en funcionamiento

    Este es otro de los puntos buenos del que podemos aprender. Si bien fueron muchos los que tenían energía eléctrica en sus centros de cómputo, no tenían acceso a ellos por fallas en algún punto de las comunicaciones.


    Algo que no falló del todo sino hasta unas cuantas horas dentro del apagón fueron los servicios de datos de celulares. Esto quiere decir que podemos aprovechar tecnologías modernas de comunicaciones como SDWAN y apalancarlas por medio de servicios de respaldo como líneas de celulares.


    Está claro que no es para reemplazar los servicios de acceso remoto, sino para ofrecer una vía adicional.


    Si los servicios de datos de celulares demostraron funcionar como lo hicieron, deberíamos considerar adoptarlos como backup.


    Acceso a la información vital para la operación

    Claramente este es uno de los puntos malos del que tenemos que aprender.


    Tener la información almacenada en nuestros servicios web y no poder acceder a los mismos por falta de comunicaciones es algo que no se debe repetir.


    Desde no contar con una copia en otro servicio online de ese documento con el procedimiento de la configuración de la VPN o, mucho más grave, el procedimiento de apagado del centro de cómputos.


    Tuvimos un caso donde llegamos a minutos de tener que apagar todo el centro de cómputos y no había acceso al procedimiento de apagado ordenado.


    Si tenemos la información publicada desde nuestro centro de cómputos, deberíamos contar con parte de esta información replicada en otro servicio que permita el acceso en caso de ser necesario.


    Las decisiones se toman antes

    Dentro de los puntos malos quiero hablar también de la falta de planificación para este tipo de escenarios. Si bien lo más común a analizar, y crear, es un plan de recuperación de desastres, diferentes escenarios tienen que ser planteados.


    Dentro de la práctica de DRP siempre tenemos que analizar diferentes escenarios, como el de un apagón o un evento prolongado que impactará en el servicio. 


    Esos escenarios se plantean durante la etapa de creación del plan y ante cada uno de éstos, se definen las acciones a tomar. Hacer esto con tanta anticipación permite tomar decisiones mucho más acertadas.


    Durante el apagón encontramos muchos casos donde no había definiciones realizadas ante los eventos y encontramos mucha improvisación.


    Este evento debería disparar inmediatamente una revisión de tu plan de recuperación de desastres si existe, o de lo contario, la creación de uno.


    Las pruebas son clave

    Para el final, dejo el feo, el peor punto de todos los puntos a mi gusto.


    Encontramos un caso, de los que tomamos contacto inicial, que al consultar el estado de sus servicios nos informó que las UPS habían soportado la carga y que en breve darían arranque al generador de forma manual.


    Nos informó que tenían combustible suficiente para operar por horas una vez el generador entrara en régimen y que estaban sin dificultades.


    El generador nunca arrancó, las baterías se agotaron y el resto… es historia. 


    En este caso había un plan de pruebas trimestral del generador.


    Un plan que no se ejecutaba hacía dos años. Sí, dos años.


    Con el diario del lunes es fácil escribir estas reflexiones.


    Durante el incidente, en algunos casos, se vivieron momentos de crisis que se podrían haber evitado con planificación, con pruebas y con un plan de recuperación de desastres que ni siquiera se hubiera llegado a disparar por completo.


    No hay que esperar a otro apagón para planificar y hacer las definiciones ahora, cuando estamos tranquilos.


    No podemos esperar a chocar el auto para contratar el seguro.


    De todo esto tenemos que aprender. De lo bueno, de lo malo y de lo feo.


    ¿Te interesa saber más sobre las buenas prácticas de DRP? Contactanos https://wetcom.com/contacto

  • Wetcom adquiere una nueva competencia Veeam

    Wetcom adquiere una nueva competencia Veeam

    Partner Acreditado de Veeam

    Veeam® Software cuenta con un programa especial denominado Veeam Accredited Service Partner(VASP, por sus siglas en inglés) mediante el cual reconoce, supervisa y promueve la calidad de los servicios profesionales prestados por un grupo exclusivo de partners.


    Wetcom adquiere una nueva competencia Veeam


    Wetcom ha sido reconocido como partner acreditado de Veeam por reunir no solo las destrezas técnicas necesarias y  el nivel de certificación requeridos, sino una exitosa trayectoria de implementaciones por personal dedicado.


    Las implementaciones son cada vez más complejas y los clientes demandan servicios de calidad. Wetcom, como miembro del programa VASPpuede responder satisfactoriamente a las demandas. «Estamos muy contentos por haber sido elegidos miembros del programa VASP. Es un reconocimiento no solo del nivel técnico de Wetcom, sino de las necesidades del negocio de nuestros clientes», aseguró Nicolás Solop, Service Operations Manager de Wetcom. 


    «Consideramos que Veeam es un partner tecnológico clave para nosotros porque nos permite proporcionar soluciones de disponibilidad de datos y recuperación en caso de desastre. Prestar servicios de calidad y acelerar los procesos de IT de nuestros clientes es nuestro foco, y que Veeam nos reconozca como partner certificado nos motiva a seguir apostando a la inversión en educación y a la excelencia de todos nuestros servicios», concluyó Solop.


    En un mercado altamente competitivo, Wetcom busca diferenciarse de la competencia y este nuevo programa de Veeam, nos aporta ese valor agregado que siempre buscamos. 


    Como parte de la membresía, Veeam permite que los usuarios finales puedan consultar la lista de miembros VASP en su página web.  Estamos cerca tuyo. ¡Buscanos! https://www.veeam.com/find-a-veeam-accredited-service-partner.html